أزمة معايير الذكاء الاصطناعي في الصين: حين تفقد الدرجات شبه الكاملة معناها
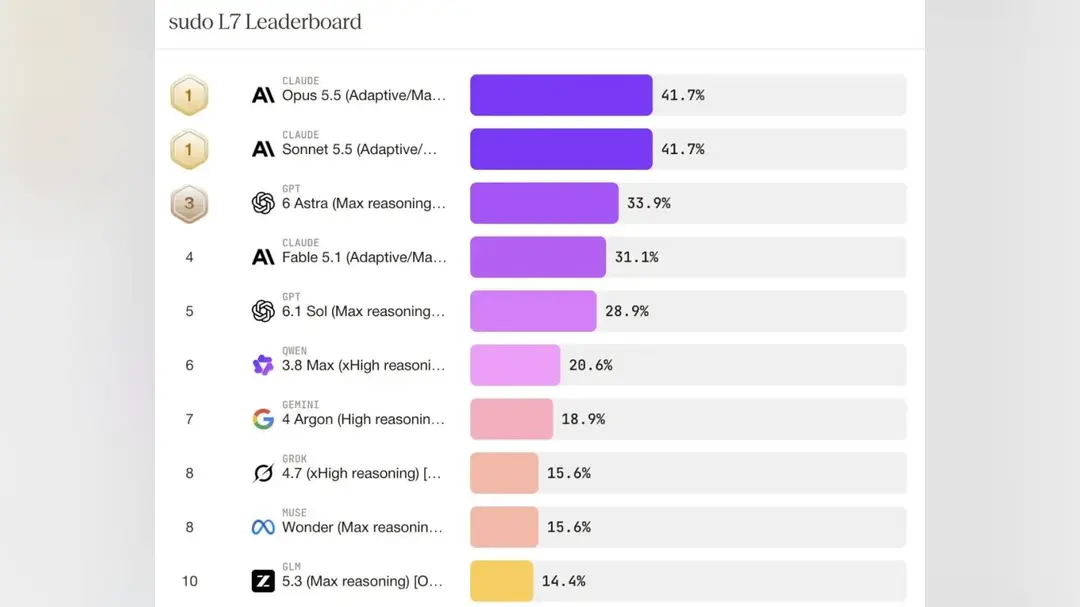
لسنوات، كان أسرع طريق لتقييم نموذج لغوي كبير هو النظر إلى درجته في معيار عام. في أكتوبر 2026، هذه العادة تتفكك. وفقًا لمجمّع التقييم المستقل BenchLM، من بين 710 معايير يتتبعها حتى 26 أكتوبر، هناك 295 اختبارًا قائمًا على النسب المئوية بتغطية ذات معنى — و105 منها، أي نحو 36%، أصبحت الآن مشبعة فعليًا، إذ يتجاوز النموذج الأول درجة 90 في كل منها.
حين تتزاحم كل النماذج الرائدة عند السقف، لم يعد فارق نقطة أو نقطتين يخبر المشتري أي نظام أقوى. لوحات الصدارة القديمة تقترب من الدرجات الكاملة في وقت تُظهر فيه تقييمات أحدث وأكثر عملية صورة مختلفة: النماذج التي تتفوق في أسئلة الكتب المدرسية تفشل مجتمعة في الاختبارات العملية. والنتيجة إعادة تقييم لسمعة تصنيفات الذكاء الاصطناعي نفسها، إذ يتحول التقييم إلى عمل تجاري، وتبدأ الشركات التي تختار نموذجًا في حساب التكلفة لكل مهمة بدلًا من مطاردة الترتيب.
الفجوة التقنية وراء هذا التحول ظاهرة في بحث جديد. ورقة أعدّتها جامعة تسينغهوا وZhipu AI بالاشتراك، وتانغ جيه مؤلفها المراسل، تقدّم نموذجًا يُسمى GLM-Omni. وتفيد بدقة 54% في توليد الصور لكن 14.57% فقط في الإجابة عن أسئلة نصية — انقسام يُظهر كيف يمكن لنظام واحد أن يبدو قويًا في لوحة صدارة وهشًا في أخرى. سرعان ما ربط مستخدمو وسائل التواصل الورقة بإصدار محتمل لـ GLM-5.5، رغم أن الورقة لا تؤكد أي مطابقة إصدارات.
Zhipu من أشهر مطوري نماذج الذكاء الاصطناعي في الصين، انبثقت من أبحاث تسينغهوا ومدرجة في هونغ كونغ. تشير نتائج GLM-Omni إلى أن الجولة المقبلة من المنافسة لن تُكسب بتصدّر مخطط واحد. النماذج الموحّدة التي تتعامل مع الرؤية واللغة معًا تُقيَّم بقدرتها على إنجاز العمل فعليًا: قراءة مستند، وتوليد صورة قابلة للاستخدام، والإجابة عن سؤال عميل دون هلوسة.
المنطق نفسه يدفع صناعة التقييم ذاتها نحو اختبارات أصعب. المعايير المبنية على أسئلة الاختيار من متعدد رخيصة التشغيل ويسهل التلاعب بها عبر تداخل بيانات التدريب؛ أما المهام الوكيلية التي تتطلب من النموذج التخطيط واستخدام الأدوات والتعافي من الأخطاء فهي مكلفة وبطيئة لكنها أقرب بكثير إلى ما تدفع الشركات مقابله. معدل التشبع البالغ 36% تحذير بأن القياسات السهلة قد استُنفدت.
بالنسبة للمشترين العالميين، النتيجة العملية تغيّر في المشتريات. فبدلًا من السؤال عن النموذج صاحب المركز الأول، تُجري الفرق على نحو متزايد تجاربها الصغيرة على سير عمل حقيقية وتقارن التكلفة الإجمالية، بما فيها رسوم الاستدلال وإعادة المحاولات. ومطوّرو النماذج الصينيون، في مواجهة منافسة سعرية محلية حادة، لديهم حافز لنشر النتائج في هذه التقييمات الأصعب — لكن أيضًا لانتقاء ما يفوزون فيه.
الإشارة التالية هي ما إذا كان المقيّمون المستقلون قادرين على مواكبة الوتيرة. إذا استمرت المعايير المشبعة في تصدّر العناوين بينما تبقى الاختبارات العملية مجزأة، فستتسع الفجوة بين السمعة والأداء الفعلي — وستكون الشركات التي تبني أدوات تقييمها الخاصة هي من يعقد الرهانات الأفضل.