चीन का AI बेंचमार्क संकट: जब लगभग पूर्ण स्कोर का कोई अर्थ नहीं रह जाता
वर्षों तक, किसी बड़े भाषा मॉडल को आंकने का सबसे तेज़ तरीका सार्वजनिक बेंचमार्क पर उसका स्कोर देखना था। अक्टूबर 2026 में, यह आदत टूट रही है। तृतीय-पक्ष मूल्यांकन एग्रीगेटर BenchLM के अनुसार, 26 अक्टूबर तक यह जिन 710 बेंचमार्क की निगरानी करता है, उनमें से 295 सार्थक कवरेज वाले प्रतिशत-आधारित परीक्षण हैं — और उनमें से 105, यानी लगभग 36%, अब प्रभावी रूप से संतृप्त हैं, जहाँ शीर्ष रैंक वाला मॉडल हर एक पर 90 से ऊपर स्कोर करता है।
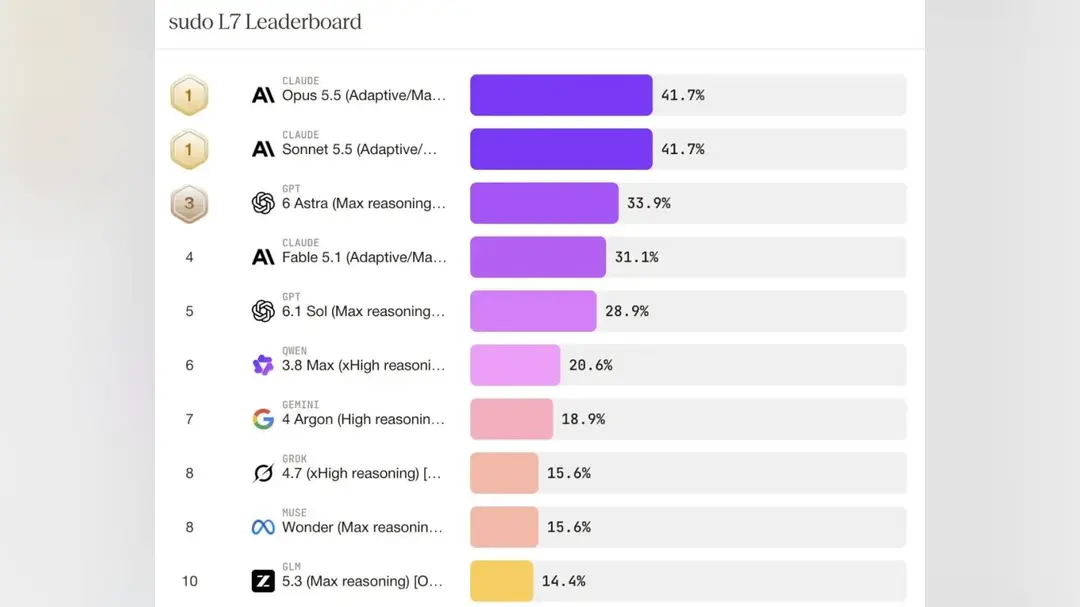
जब हर अग्रणी मॉडल छत पर भीड़ लगा देता है, तो एक या दो अंक का अंतर खरीदार को यह नहीं बताता कि कौन सा सिस्टम अधिक मजबूत है। पुराने लीडरबोर्ड पूरे अंकों के करीब पहुँच रहे हैं, ठीक तभी नए, अधिक व्यावहारिक मूल्यांकन एक अलग तस्वीर पेश कर रहे हैं: जो मॉडल पाठ्यपुस्तक के सवालों में शानदार हैं, वे व्यावहारिक परीक्षणों में सामूहिक रूप से विफल हो रहे हैं। नतीजा AI रैंकिंग की ही क्रेडिट पुनर्मूल्यांकन है, क्योंकि मूल्यांकन एक व्यवसाय बन रहा है और मॉडल चुनने वाली कंपनियाँ रैंक का पीछा करने के बजाय प्रति-कार्य लागत की गणना करने लगी हैं।
इस बदलाव के पीछे का तकनीकी अंतर नए शोध में दिखता है। सिंघुआ विश्वविद्यालय और ज़िपू AI द्वारा संयुक्त रूप से तैयार किया गया एक पेपर, जिसके संवाददाता लेखक तांग जी हैं, GLM-Omni नामक एक मॉडल पेश करता है। यह इमेज जनरेशन में 54% सटीकता बताता है लेकिन टेक्स्ट प्रश्न उत्तर में केवल 14.57% — यह विभाजन दिखाता है कि कैसे एक ही सिस्टम एक लीडरबोर्ड पर मजबूत और दूसरे पर कमजोर दिख सकता है। सोशल मीडिया उपयोगकर्ताओं ने पेपर को जल्दी ही संभावित GLM-5.5 रिलीज़ से जोड़ दिया, हालाँकि पेपर किसी संस्करण मैपिंग की पुष्टि नहीं करता।
ज़िपू चीन के सबसे प्रसिद्ध AI मॉडल डेवलपर्स में से एक है, जो सिंघुआ शोध से निकला और हांगकांग में सूचीबद्ध है। GLM-Omni के नतीजे बताते हैं कि प्रतिस्पर्धा का अगला दौर किसी एक चार्ट में शीर्ष पर पहुँचकर नहीं जीता जाएगा। दृष्टि और भाषा को साथ संभालने वाले एकीकृत मॉडलों का आकलन इस पर हो रहा है कि वे वास्तव में काम पूरा कर सकते हैं या नहीं: दस्तावेज़ पढ़ना, उपयोगी इमेज बनाना, ग्राहक के सवाल का बिना भ्रम पैदा किए जवाब देना।
यही तर्क मूल्यांकन उद्योग को ही कठिन परीक्षणों की ओर धकेल रहा है। बहुविकल्पीय प्रश्नों पर बने बेंचमार्क चलाने में सस्ते और प्रशिक्षण-डेटा ओवरलैप से आसानी से धोखा दिए जा सकते हैं; एजेंटिक कार्य जिनमें मॉडल को योजना बनानी होती है, उपकरण इस्तेमाल करने होते हैं और गलतियों से उबरना होता है, महँगे और धीमे हैं लेकिन उद्यम जिसके लिए भुगतान करते हैं उसके बहुत करीब। 36% संतृप्ति दर एक चेतावनी है कि आसान माप खत्म हो चुके हैं।
वैश्विक खरीदारों के लिए व्यावहारिक परिणाम खरीद में बदलाव है। टीमें यह पूछने के बजाय कि कौन सा मॉडल पहले स्थान पर है, वास्तविक कार्यप्रवाहों पर अपने छोटे परीक्षण चला रही हैं और अनुमान शुल्क तथा पुनः प्रयासों सहित कुल लागत की तुलना कर रही हैं। घरेलू तीव्र मूल्य प्रतिस्पर्धा का सामना कर रहे चीनी मॉडल निर्माताओं के पास इन कठिन मूल्यांकनों पर नतीजे प्रकाशित करने का प्रोत्साहन है — लेकिन यह भी कि जो वे जीतते हैं उन्हीं को चुन लें।
अगला संकेत यह होगा कि क्या स्वतंत्र मूल्यांकनकर्ता गति बनाए रख पाते हैं। यदि संतृप्त बेंचमार्क सुर्खियों पर हावी रहते हैं जबकि व्यावहारिक परीक्षण बिखरे रहते हैं, तो प्रतिष्ठा और वितरण के बीच का अंतर बढ़ेगा — और जो कंपनियाँ अपने स्वयं के मूल्यांकन ढाँचे बनाती हैं, वही बेहतर दाँव लगाएँगी।