Krisis Tolok Ukur AI Tiongkok: Ketika Skor Nyaris Sempurna Tak Lagi Bermakna
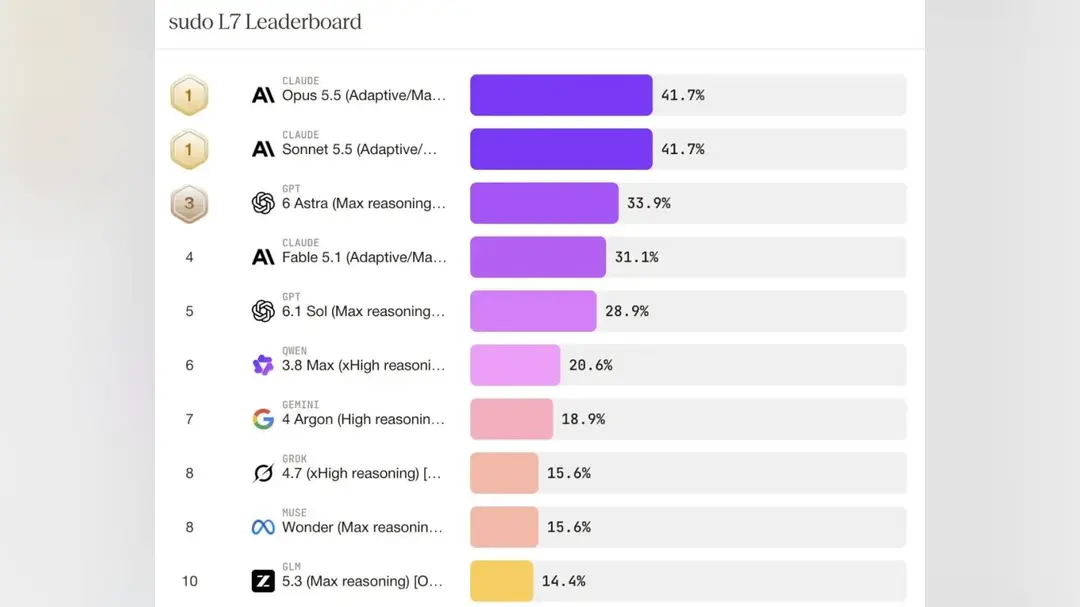
Selama bertahun-tahun, cara tercepat menilai sebuah model bahasa besar adalah melihat skornya pada tolok ukur publik. Pada Oktober 2026, kebiasaan itu mulai runtuh. Menurut agregator evaluasi pihak ketiga BenchLM, dari 710 tolok ukur yang dilacaknya per 26 Oktober, 295 merupakan uji berbasis persentase dengan cakupan yang bermakna — dan 105 di antaranya, sekitar 36%, kini praktis jenuh, dengan model peringkat teratas mencetak skor di atas 90 pada semuanya.
Ketika setiap model terkemuka berdesakan di langit-langit, selisih satu atau dua poin tak lagi memberi tahu pembeli sistem mana yang lebih kuat. Papan peringkat lama mendekati nilai penuh justru saat evaluasi baru yang lebih praktis menghasilkan gambaran berbeda: model yang jago menjawab soal buku teks secara kolektif gagal dalam uji praktik. Hasilnya adalah penilaian ulang kredibilitas peringkat AI itu sendiri, seiring evaluasi berubah menjadi bisnis dan perusahaan yang memilih model mulai menghitung biaya per tugas alih-alih mengejar peringkat.
Kesenjangan teknis di balik pergeseran itu terlihat dalam riset terbaru. Sebuah makalah yang disusun bersama oleh Universitas Tsinghua dan Zhipu AI, dengan Tang Jie sebagai penulis korespondensi, memperkenalkan model bernama GLM-Omni. Model ini melaporkan akurasi 54% pada pembuatan gambar tetapi hanya 14,57% pada tanya jawab teks — perbedaan yang menunjukkan bagaimana satu sistem bisa tampak kuat di satu papan peringkat dan rapuh di papan lain. Pengguna media sosial dengan cepat mengaitkan makalah itu dengan kemungkinan rilis GLM-5.5, meski makalah tersebut tidak mengonfirmasi pemetaan versi apa pun.
Zhipu adalah salah satu pengembang model AI paling dikenal di Tiongkok, hasil pemisahan dari riset Tsinghua dan tercatat di Hong Kong. Hasil GLM-Omni menunjukkan bahwa putaran kompetisi berikutnya tidak akan dimenangkan dengan menduduki puncak satu grafik. Model terpadu yang menangani visi dan bahasa sekaligus dinilai berdasarkan apakah mereka benar-benar dapat menyelesaikan pekerjaan: membaca dokumen, menghasilkan gambar yang layak pakai, menjawab pertanyaan pelanggan tanpa berhalusinasi.
Logika yang sama mendorong industri evaluasi itu sendiri menuju uji yang lebih sulit. Tolok ukur berbasis soal pilihan ganda murah dijalankan dan mudah dicurangi melalui tumpang tindih data pelatihan; tugas agentic yang menuntut model merencanakan, menggunakan alat, dan pulih dari kesalahan mahal dan lambat, tetapi jauh lebih dekat dengan apa yang dibayar perusahaan. Tingkat kejenuhan 36% adalah peringatan bahwa pengukuran yang mudah sudah habis.
Bagi pembeli global, konsekuensi praktisnya adalah perubahan dalam pengadaan. Alih-alih bertanya model mana yang peringkat pertama, tim semakin sering menjalankan uji kecil mereka sendiri pada alur kerja nyata dan membandingkan biaya total, termasuk biaya inferensi dan percobaan ulang. Pengembang model Tiongkok, yang menghadapi persaingan harga domestik yang ketat, punya insentif untuk menerbitkan hasil pada evaluasi yang lebih sulit ini — tetapi juga untuk memilih hanya yang mereka menangkan.
Sinyal berikutnya adalah apakah evaluator independen dapat mengimbangi laju. Jika tolok ukur yang jenuh terus mendominasi berita utama sementara uji praktis tetap terfragmentasi, jurang antara reputasi dan hasil nyata akan melebar — dan perusahaan yang membangun perangkat evaluasi mereka sendiri akan menjadi pihak yang membuat taruhan lebih baik.