중국 AI 벤치마크의 위기: 거의 완벽한 점수가 의미를 잃을 때
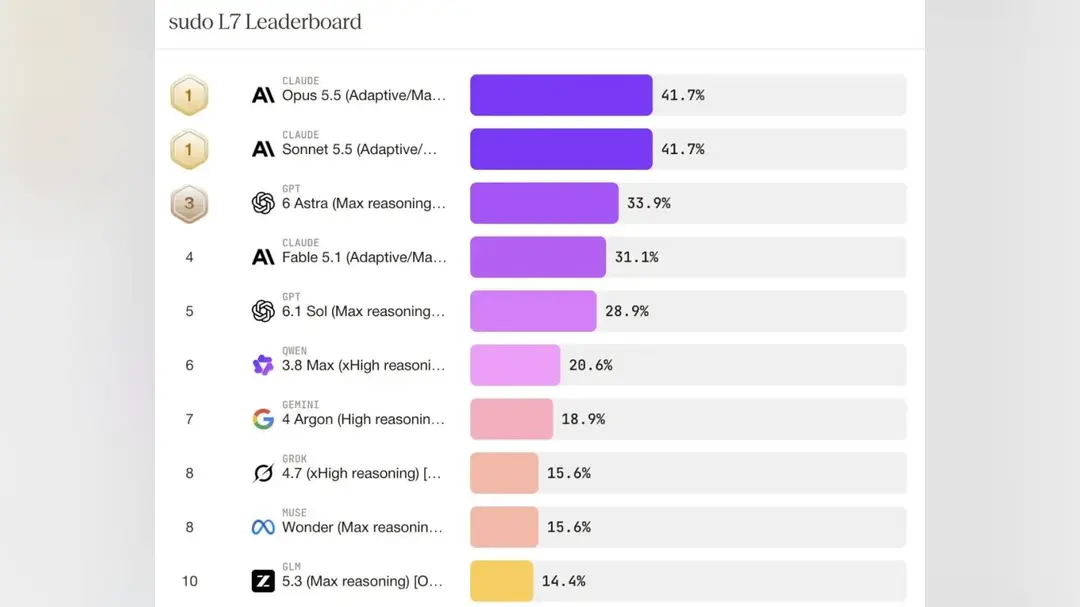
수년간 대규모 언어 모델을 평가하는 가장 빠른 방법은 공개 벤치마크 점수를 보는 것이었다. 2026년 10월, 그 관행이 무너지고 있다. 제3자 평가 집계업체 BenchLM에 따르면, 10월 26일 기준으로 추적 중인 710개 벤치마크 가운데 295개가 의미 있는 범위를 갖춘 백분율 기반 테스트이며, 그중 105개, 약 36%가 사실상 포화 상태로, 최상위 모델이 모든 테스트에서 90점을 넘는다.
모든 선도 모델이 천장에 몰리면 1~2점 차이로는 구매자에게 어느 시스템이 더 강한지 알려줄 수 없다. 오래된 리더보드가 만점에 가까워지는 동안, 더 실용적인 새로운 평가는 다른 그림을 보여준다. 교과서적인 질문에 능숙하게 답하는 모델들이 실전 테스트에서는 일제히 실패하는 것이다. 그 결과 AI 순위 자체에 대한 신용 재평가가 일어나고, 평가가 비즈니스로 변하면서 모델을 고르는 기업들은 순위를 쫓는 대신 과제당 비용을 계산하기 시작했다.
이 변화 뒤의 기술적 격차는 최신 연구에서 드러난다. 칭화대와 지푸 AI가 공동으로 작성하고 탕제가 교신저자를 맡은 논문은 GLM-Omni라는 모델을 소개한다. 이미지 생성에서는 54%의 정확도를 보고하지만 텍스트 질의응답에서는 14.57%에 그친다. 이 격차는 하나의 시스템이 한 리더보드에서는 강해 보이고 다른 리더보드에서는 취약해 보일 수 있음을 보여준다. 소셜 미디어 사용자들은 이 논문을 GLM-5.5 출시 가능성과 곧바로 연결했지만, 논문은 어떤 버전 대응도 확인하지 않는다.
지푸는 중국에서 가장 잘 알려진 AI 모델 개발사 중 하나로, 칭화대 연구에서 분사해 홍콩에 상장했다. GLM-Omni의 결과는 다음 경쟁이 단일 차트 1위로 승리하지 않을 것임을 시사한다. 시각과 언어를 함께 다루는 통합 모델은 실제로 업무를 완수할 수 있는지로 평가받고 있다. 문서를 읽고, 쓸 만한 이미지를 생성하고, 환각 없이 고객 질문에 답하는 능력이다.
같은 논리가 평가 산업 자체를 더 어려운 테스트로 밀어붙이고 있다. 객관식 질문에 기반한 벤치마크는 실행이 저렴하고 훈련 데이터 중복을 통해 쉽게 공략할 수 있다. 모델이 계획을 세우고 도구를 사용하며 오류에서 복구하도록 요구하는 에이전트형 과제는 비싸고 느리지만 기업이 실제로 지불하는 것에 훨씬 가깝다. 36%의 포화율은 쉬운 측정이 고갈되었다는 경고다.
글로벌 구매자에게 실질적인 결과는 조달 방식의 변화다. 어떤 모델이 1위인지 묻는 대신, 팀들은 실제 워크플로에서 자체 소규모 시험을 점점 더 많이 돌리고 추론 비용과 재시도를 포함한 총비용을 비교한다. 치열한 국내 가격 경쟁에 직면한 중국 모델 개발사들은 이런 더 어려운 평가 결과를 공개할 유인을 갖지만, 동시에 자신이 이기는 것만 골라 공개할 유인도 갖는다.
다음 신호는 독립 평가자들이 보조를 맞출 수 있는지다. 포화된 벤치마크가 계속 헤드라인을 장악하고 실용적 테스트가 분절된 채로 남는다면, 평판과 실제 전달 사이의 격차는 벌어질 것이며, 자체 평가 체계를 구축하는 기업들이 더 나은 베팅을 하게 될 것이다.