中國 AI 基準測試危機:當近乎滿分的成績不再說明任何事
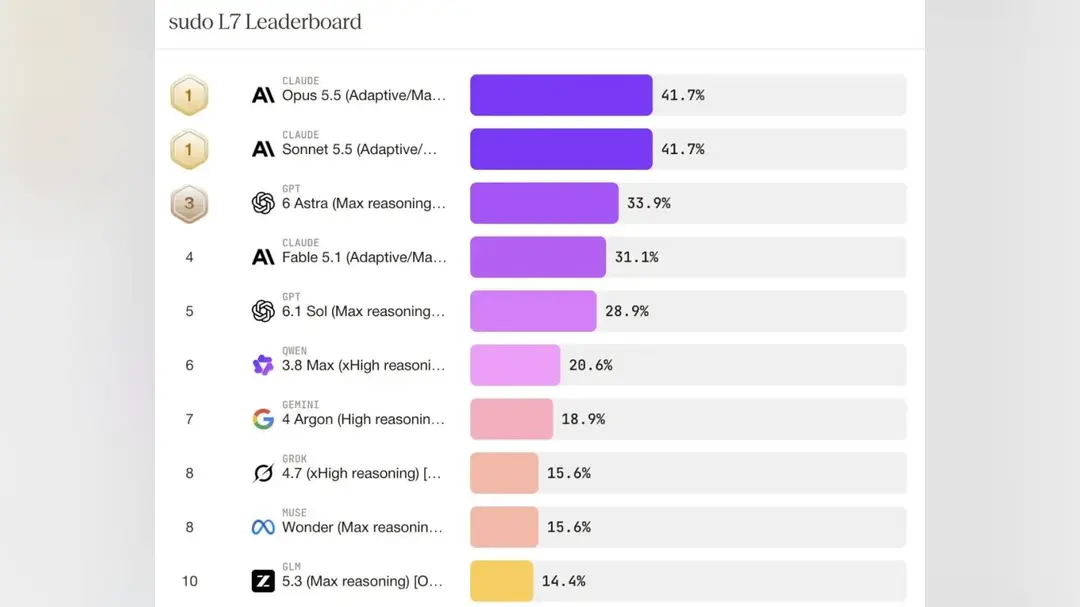
多年來,判斷一個大型語言模型最快的方法,就是看它在公開基準測試上的分數。到了 2026 年 10 月,這個習慣正在崩解。根據第三方評測彙整平台 BenchLM,截至 10 月 26 日它所追蹤的 710 項基準測試中,有 295 項是具備有意義覆蓋範圍的百分比制測驗,而其中 105 項、約 36%,如今實際上已趨於飽和,排名第一的模型在每一項上都拿下 90 分以上。
當所有領先模型都擠在天花板附近,一兩分的差距已無法告訴買方哪個系統更強。舊排行榜正逼近滿分,與此同時,更新、更貼近實務的評測卻呈現出不同的景象:在教科書題目上拿高分的模型,集體在實作測驗中失利。結果是 AI 排名本身遭到信用重估,評測變成了一門生意,而挑選模型的企業開始計算每項任務的成本,不再追逐名次。
這場轉變背後的技術落差,在新研究中清晰可見。一篇由清華大學與智譜 AI 共同發表、唐杰為通訊作者的論文,提出了一個名為 GLM-Omni 的模型。它回報影像生成準確率為 54%,但文字問答僅有 14.57%,這種落差顯示同一個系統可以在某個排行榜上看起來很強,在另一個排行榜上卻很脆弱。社群媒體使用者迅速將這篇論文與可能推出的 GLM-5.5 聯想在一起,不過論文並未確認任何版本對應關係。
智譜是中國最知名的 AI 模型開發商之一,由清華大學的研究成果分拆成立,並在香港上市。GLM-Omni 的結果顯示,下一輪競爭不會靠登上單一圖表的頂端取勝。能同時處理視覺與語言的統一模型,正被以能否真正完成工作來衡量:讀懂文件、生成可用的影像、回答客戶問題而不胡編亂造。
同樣的邏輯正把評測產業本身推向更難的測驗。以選擇題為基礎的基準測試執行成本低,也容易透過訓練資料重疊來鑽漏洞;要求模型規劃、使用工具並從錯誤中復原的代理型任務則昂貴又緩慢,卻遠更接近企業實際付費購買的東西。36% 的飽和率是一記警訊:容易的測量方式已經用盡。
對全球買方而言,實際後果是採購方式的改變。團隊不再問哪個模型排名第一,而是日益在真實工作流程上自行進行小型試用,並比較總成本,包括推論費用與重試次數。中國模型開發商面對激烈的國內價格競爭,有動機在這些更難的評測上公布結果,卻也有動機只挑自己會贏的項目。
下一個訊號將是獨立評測機構能否跟上腳步。如果飽和的基準測試持續佔據新聞版面,而實務測驗仍舊零散破碎,聲譽與實際交付之間的落差就會擴大,而自行打造評測工具的企業,才會是押對注的一方。