Khủng hoảng chuẩn đánh giá AI Trung Quốc: Khi điểm gần tuyệt đối không còn ý nghĩa
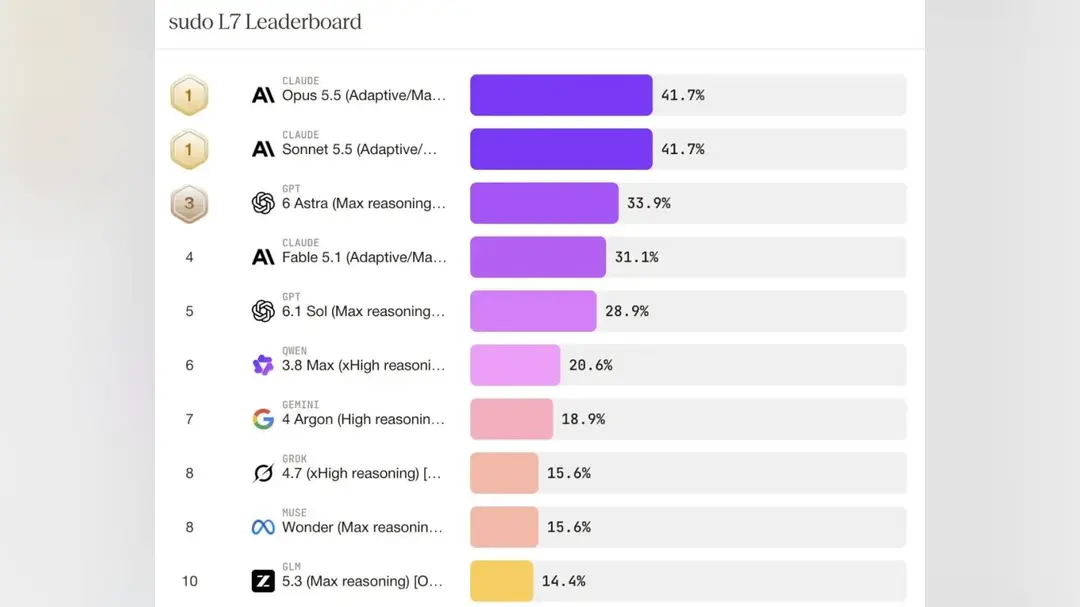
Trong nhiều năm, cách nhanh nhất để đánh giá một mô hình ngôn ngữ lớn là xem điểm của nó trên một chuẩn đánh giá công khai. Đến tháng 10 năm 2026, thói quen đó đang sụp đổ. Theo BenchLM, đơn vị tổng hợp đánh giá bên thứ ba, trong số 710 chuẩn đánh giá mà họ theo dõi tính đến ngày 26 tháng 10, có 295 bài kiểm tra dạng phần trăm với độ phủ có ý nghĩa — và 105 trong số đó, khoảng 36%, hiện đã bão hòa trên thực tế, với mô hình xếp hạng cao nhất đạt trên 90 ở tất cả các bài.
Khi mọi mô hình hàng đầu chen chúc ở mức trần, khoảng cách một hay hai điểm không còn cho người mua biết hệ thống nào mạnh hơn. Các bảng xếp hạng cũ đang tiến gần điểm tối đa đúng lúc những đánh giá mới, thực tế hơn đang tạo ra một bức tranh khác: những mô hình giải ngon lành các câu hỏi sách giáo khoa lại đồng loạt trượt các bài kiểm tra thực hành. Kết quả là một lần đánh giá lại uy tín của chính các bảng xếp hạng AI, khi đánh giá trở thành một ngành kinh doanh và các công ty chọn mô hình bắt đầu tính chi phí mỗi tác vụ thay vì chạy theo thứ hạng.
Khoảng cách kỹ thuật đằng sau sự chuyển dịch đó hiện rõ trong nghiên cứu mới. Một bài báo do Đại học Thanh Hoa và Zhipu AI đồng thực hiện, với Tang Jie là tác giả liên hệ, giới thiệu một mô hình tên là GLM-Omni. Mô hình này báo cáo độ chính xác 54% ở tác vụ tạo ảnh nhưng chỉ 14,57% ở tác vụ hỏi đáp văn bản — sự chênh lệch cho thấy một hệ thống duy nhất có thể trông mạnh trên bảng xếp hạng này và mong manh trên bảng khác. Người dùng mạng xã hội nhanh chóng liên hệ bài báo với khả năng phát hành GLM-5.5, dù bài báo không xác nhận bất kỳ ánh xạ phiên bản nào.
Zhipu là một trong những nhà phát triển mô hình AI được biết đến nhiều nhất của Trung Quốc, tách ra từ nghiên cứu của Thanh Hoa và niêm yết tại Hồng Kông. Kết quả GLM-Omni cho thấy vòng cạnh tranh tiếp theo sẽ không được thắng bằng cách đứng đầu một biểu đồ duy nhất. Các mô hình hợp nhất xử lý cả thị giác và ngôn ngữ đang được đánh giá dựa trên việc liệu chúng có thực sự hoàn thành công việc hay không: đọc tài liệu, tạo ra một hình ảnh dùng được, trả lời câu hỏi của khách hàng mà không bịa đặt.
Logic tương tự đang đẩy chính ngành đánh giá về phía những bài kiểm tra khó hơn. Các chuẩn đánh giá dựa trên câu hỏi trắc nghiệm rẻ để chạy và dễ bị gian lận nhờ dữ liệu huấn luyện trùng lặp; các tác vụ tác tử đòi hỏi mô hình phải lập kế hoạch, sử dụng công cụ và phục hồi sau lỗi thì tốn kém và chậm nhưng gần hơn nhiều với thứ mà doanh nghiệp phải trả tiền. Tỷ lệ bão hòa 36% là lời cảnh báo rằng những phép đo dễ đã bị dùng hết.
Với người mua toàn cầu, hệ quả thực tế là sự thay đổi trong mua sắm. Thay vì hỏi mô hình nào xếp hạng nhất, các nhóm ngày càng tự chạy những thử nghiệm nhỏ trên quy trình làm việc thực tế và so sánh tổng chi phí, gồm phí suy luận và các lần thử lại. Các nhà phát triển mô hình Trung Quốc, đối mặt với cạnh tranh giá gay gắt trong nước, có động lực công bố kết quả trên những đánh giá khó hơn này — nhưng cũng có động lực chỉ chọn những bài họ thắng.
Tín hiệu tiếp theo là liệu các đơn vị đánh giá độc lập có theo kịp hay không. Nếu các chuẩn đánh giá bão hòa tiếp tục thống trị tiêu đề trong khi các bài kiểm tra thực tế vẫn manh mún, khoảng cách giữa danh tiếng và hiệu quả thực tế sẽ nới rộng — và những công ty tự xây dựng bộ công cụ đánh giá của riêng mình sẽ là những người đặt cược tốt hơn.