Çin'in yapay zekâ kıyaslama krizi: Neredeyse kusursuz puanlar anlamını yitirdiğinde
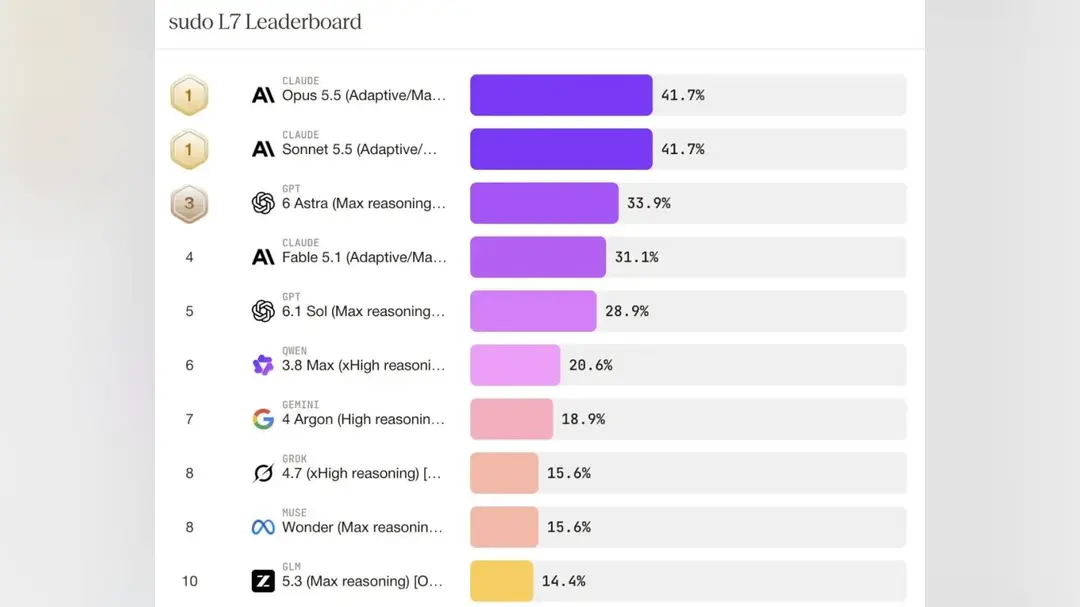
Yıllar boyunca büyük bir dil modelini değerlendirmenin en hızlı yolu, kamuya açık bir kıyaslamadaki puanına bakmaktı. Ekim 2026’da bu alışkanlık çözülüyor. Üçüncü taraf değerlendirme toplayıcısı BenchLM’ye göre, 26 Ekim itibarıyla izlediği 710 kıyaslamadan 295’i anlamlı kapsama sahip yüzde tabanlı testler — ve bunların 105’i, yani yaklaşık %36’sı artık fiilen doymuş durumda; en üst sıradaki model her birinde 90’ın üzerinde puan alıyor.
Her önde gelen model tavana dayandığında, bir veya iki puanlık fark artık alıcıya hangi sistemin daha güçlü olduğunu söylemiyor. Eski sıralama tabloları tam puana yaklaşırken daha yeni ve pratik değerlendirmeler farklı bir tablo ortaya koyuyor: ders kitabı sorularını kolayca geçen modeller, uygulamalı testlerde topluca başarısız oluyor. Sonuç, değerlendirme bir işe dönüşürken ve model seçen şirketler bir sıralamanın peşinden koşmak yerine görev başına maliyeti hesaplamaya başlarken, yapay zekâ sıralamalarının kendisine yönelik bir kredi yeniden değerlendirmesi.
Bu değişimin ardındaki teknik uçurum yeni araştırmalarda görülüyor. Tsinghua Üniversitesi ve Zhipu AI tarafından ortaklaşa üretilen ve sorumlu yazarı Tang Jie olan bir makale, GLM-Omni adlı bir modeli tanıtıyor. Model, görsel üretimde %54 doğruluk bildirirken metin soru yanıtlamada yalnızca %14,57 — bu ayrım, tek bir sistemin bir sıralamada güçlü, diğerinde kırılgan görünebileceğini gösteriyor. Sosyal medya kullanıcıları makaleyi hızla olası bir GLM-5.5 sürümüne bağladı, ancak makale herhangi bir sürüm eşlemesini doğrulamıyor.
Zhipu, Tsinghua araştırmalarından doğan ve Hong Kong’da işlem gören, Çin’in en tanınmış yapay zekâ modeli geliştiricilerinden biri. GLM-Omni sonuçları, bir sonraki rekabet turunun tek bir grafiğin zirvesine çıkarak kazanılmayacağını gösteriyor. Görü ve dili birlikte işleyen birleşik modeller, gerçekten iş tamamlayıp tamamlayamadıklarına göre değerlendiriliyor: bir belgeyi okumak, kullanılabilir bir görsel üretmek, bir müşteri sorusunu halüsinasyon görmeden yanıtlamak.
Aynı mantık, değerlendirme sektörünü de daha zor testlere doğru itiyor. Çoktan seçmeli sorulara dayanan kıyaslamaları çalıştırmak ucuz ve eğitim verisi örtüşmesiyle atlatmak kolay; bir modelin plan yapmasını, araç kullanmasını ve hatalardan toparlanmasını gerektiren ajan tabanlı görevler pahalı ve yavaş ama işletmelerin parasını ödediği şeye çok daha yakın. %36’lık doyma oranı, kolay ölçümlerin tükendiğine dair bir uyarı.
Küresel alıcılar için pratik sonuç, satın almada bir değişiklik. Ekipler hangi modelin birinci olduğunu sormak yerine, gerçek iş akışlarında giderek kendi küçük denemelerini yapıyor ve çıkarım ücretleri ile yeniden denemeler dahil toplam maliyeti karşılaştırıyor. Yoğun iç fiyat rekabetiyle karşı karşıya olan Çinli model üreticileri, bu daha zor değerlendirmelerde sonuç yayımlama — ama aynı zamanda kazandıklarını seçme — teşvikine sahip.
Bir sonraki sinyal, bağımsız değerlendiricilerin hızı yetiştirip yetişemeyeceği olacak. Doymuş kıyaslamalar manşetlere hâkim olmaya devam ederken pratik testler parçalı kalırsa, itibar ile teslimat arasındaki uçurum genişleyecek — ve kendi değerlendirme altyapılarını kuran şirketler daha iyi bahisleri yapanlar olacak.