中国AIベンチマークの危機:ほぼ完璧なスコアが意味をなさなくなるとき
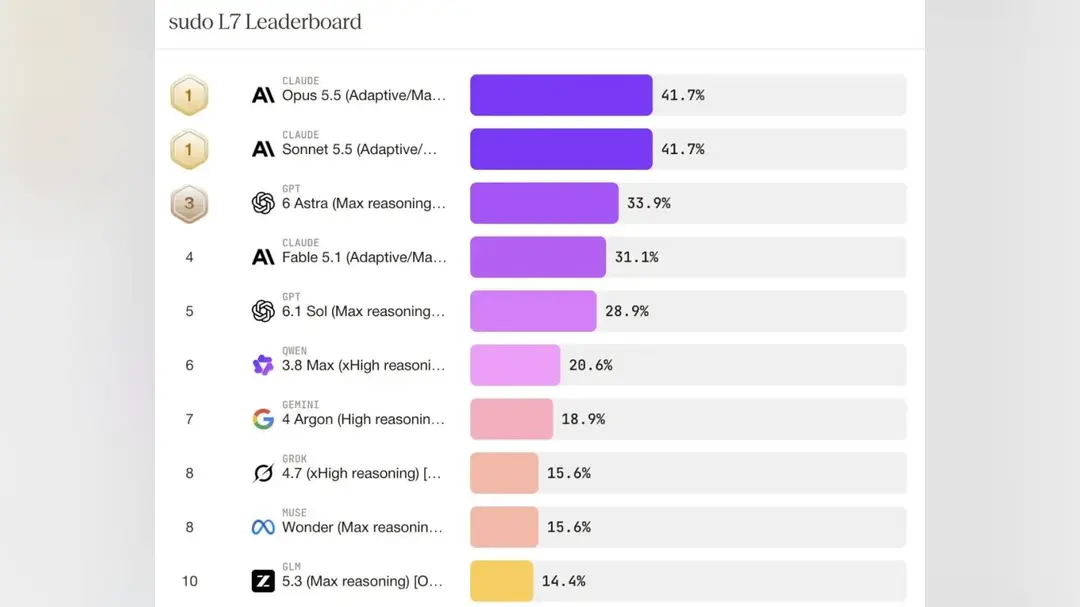
長年、大規模言語モデルを評価する最速の方法は、公開ベンチマークでのスコアを見ることだった。2026年10月、その習慣が崩れつつある。第三者評価アグリゲーターのBenchLMによると、10月26日時点で追跡している710のベンチマークのうち、295が意味のある範囲をカバーするパーセンテージベースのテストであり、そのうち105、約36%が実質的に飽和状態にある。首位のモデルはそのすべてで90を超えるスコアを出している。
主要モデルがすべて天井にひしめくと、1点や2点の差では購入者にどちらのシステムが強いかを伝えられない。古いリーダーボードが満点に近づく一方で、より実用的な新しい評価は別の姿を映し出している。教科書的な問題に見事に答えるモデルが、実践的なテストではそろって失敗するのだ。その結果、AIランキング自体の信用が再評価され、評価がビジネスへと変わる中、モデルを選ぶ企業は順位を追うのではなくタスクあたりのコストを計算し始めている。
この変化の背景にある技術的なギャップは、最新の研究に表れている。清華大学と智譜AIが共同で作成し、唐傑氏が責任著者を務める論文は、GLM-Omniと呼ばれるモデルを紹介している。画像生成では54%の精度を報告する一方、テキストの質問応答ではわずか14.57%だ。この乖離は、単一のシステムが一方のリーダーボードでは強く見え、別のリーダーボードでは脆く見えることを示している。ソーシャルメディアのユーザーはすぐにこの論文をGLM-5.5のリリースの可能性と結びつけたが、論文はいかなるバージョンの対応も確認していない。
智譜は中国で最も知られたAIモデル開発企業の一つで、清華大学の研究からスピンアウトし、香港に上場している。GLM-Omniの結果は、次の競争が単一のチャートの首位を取ることでは勝てないことを示唆する。視覚と言語を統合して扱うモデルは、実際に仕事を完遂できるかどうかで評価されている。文書を読み、使える画像を生成し、顧客の質問に幻覚を起こさず答えることができるか、という基準だ。
同じ論理が、評価業界そのものをより難しいテストへと押しやっている。多肢選択式の質問に基づくベンチマークは実施が安価で、訓練データの重複を通じて容易に攻略できる。モデルが計画を立て、ツールを使い、エラーから回復することを求めるエージェント型タスクは高コストで時間がかかるが、企業が実際に支払う内容にはるかに近い。36%という飽和率は、簡単な測定が使い果たされたことへの警告だ。
世界の購入者にとっての実際的な帰結は、調達方法の変化である。どのモデルが首位かと尋ねる代わりに、チームは実際のワークフローで独自の小規模な試行を重ね、推論費用や再試行を含む総コストを比較するようになっている。中国のモデル開発企業は、国内の激しい価格競争に直面し、こうしたより難しい評価の結果を公表する動機を持つ一方で、勝てるものだけを選び出す動機も持つ。
次のシグナルは、独立した評価者が追随できるかどうかだ。飽和したベンチマークが引き続き見出しを占め、実用的なテストが断片化したままであれば、評判と実態の差は広がる。そして独自の評価基盤を構築する企業こそが、より良い賭けをするだろう。