텐센트, 인간 지연시간 앞서는 동시통역 모델 오픈소스 공개
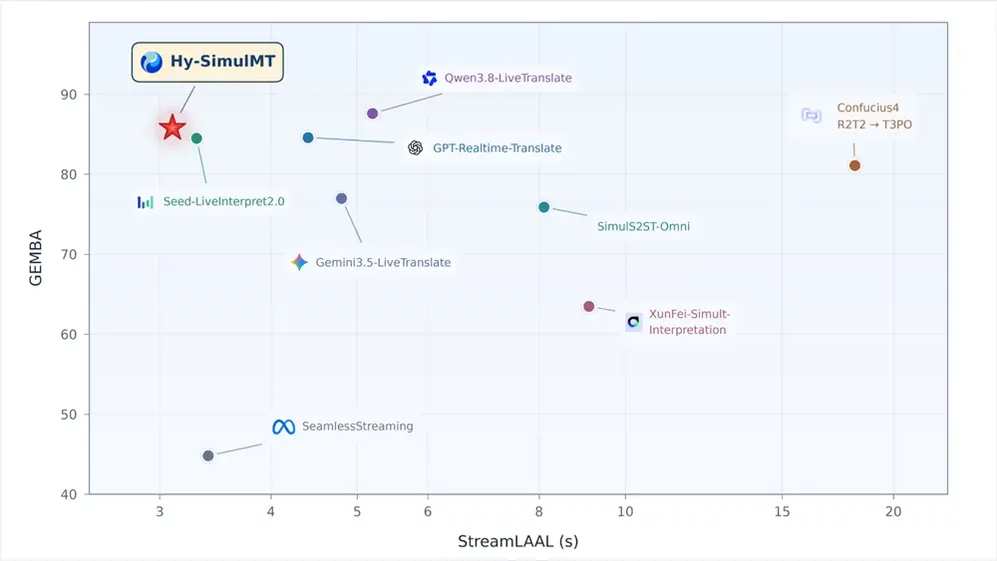
텐센트의 훈위안(Hunyuan) 연구팀은 10월 26일 동시통역 모델 ‘Hy-SimulMT’를 공개하고 오픈소스화했다. 방음 부스에 들어간 훈련된 인간이 보통 필요한 동시통역을 위해 만들어졌다. 이 모델은 화자의 오디오를 입력받아 화자가 아직 말하는 동안 번역된 음성을 출력하며, 문장이 끝나기를 기다리지 않고 중국어와 영어 사이를 양방향으로 오간다.
핵심 숫자는 지연시간이다. 텐센트는 시스템이 약 3초 만에 응답한다고 밝혔다. 전문 인간 동시통역사의 평균 4~5초보다 빠르다. 동시통역에서 이 몇 초가 전부다. 지연이 길수록 청중은 맥락을 놓치고, 화자와 통역사가 동기화를 유지하기도 어려워진다. 회사는 또 여러 평가에서 번역 품질이 인간 회의 통역사 수준에 도달해 주류 오픈소스 모델과 대부분의 상용 API를 앞선다고 주장한다.
번역 업계 밖에서 가장 주목받을 기능은 실시간 음색 복제다. Hy-SimulMT는 출력 오디오에서 화자의 목소리와 억양을 재현해, 중국어 화자의 영어가 일반 합성 음성이 아니라 그 사람처럼 들리게 한다. 회의와 라이브 방송, 여행에 의미 있는 진전이지만, 복제가 가능한 시스템이 늘 불러오는 음성 데이터와 동의에 관한 익숙한 질문도 제기한다.
텐센트는 이 모델을 번역 앱 ‘Hy’에 무료 체험용으로 넣었고, 코드와 가중치는 HuggingFace, ModelScope, GitHub에서 이용할 수 있다. API 뒤에 두지 않고 모델을 공개하는 것은 중국 AI 연구소에서 흔한 방식이다. 개발자 생태계와 신뢰를 쌓기 위해 공개 배포를 자주 활용하는 반면, 상용 경쟁사는 최고 시스템을 비공개로 유지한다.
동시통역은 경쟁이 치열한 최전선이 됐다. 이 문제는 낮은 지연, 안정적 출력, 뒤섞이고 겹치는 음성 처리 능력을 보상하기에 AI에 잘 맞는다. 모두 대규모 음성 모델이 급격히 개선된 분야다. 또한 명확하고 측정 가능한 인간 기준이 있는 드문 AI 과제 중 하나다. 전문 통역사의 속도와 정확성은 누구나 이해할 수 있는 척도가 된다.
전 세계 사용자에게 실질적 효과는 통역사 대체보다 접근성 확대에 가깝다. 휴대폰에서 돌아가는 3초 음성 대 음성 파이프라인은 서비스를 예약하지 않고도 언어 장벽을 넘어 비즈니스 통화, 공장 견학, 병원 대화를 가능하게 할 수 있다. 음성 복제 층은 경험을 덜 기계적으로 느끼게 하지만, 화자가 하지 못하는 언어로 그 사람의 말투를 흉내 낼 수 있다는 뜻이기도 하다.
다음 시험은 실제 사용이다. 앱 리뷰와 오픈 가중치로 만든 개발자 프로젝트는 3초 응답이 시끄러운 오디오, 강한 억양, 전문 용어에서도 버티는지 보여줄 것이다. 실험실 평가가 모델에 후한 경우가 많은 영역이다. 텐센트의 행보는 경쟁사에 비교 가능한 지연 수치를 공개하라는 압력도 준다. 그러면 지금까지 주로 데모 영상으로 움직여 온 시장을 구매자가 더 명확히 판단할 수 있게 된다.