바이두의 새 OCR 모델, 해리 포터 7권을 한 번에 읽다
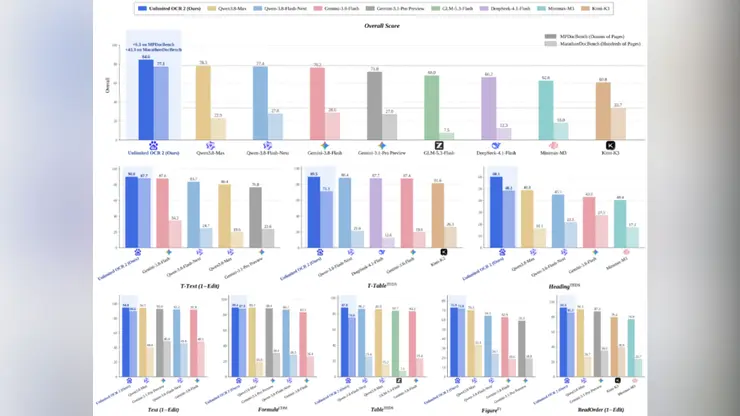
텍스트 이미지를 편집 가능한 단어로 바꾸는 기술인 광학 문자 인식(OCR)에는 오랫동안 한계가 있었다. 대부분의 시스템은 수십 페이지를 처리하면 정확도가 떨어지거나 메모리 사용량이 급증한다. 바이두는 10월 27일 ‘Wenxin Unlimited OCR 2’라는 모델을 공개하고 오픈소스로 전환했다. 이 모델이 그 한계를 완전히 없앴다고 회사는 주장한다.
회사는 이번 공개를 어떤 모델이든 임의 페이지 문서 분석을 처음으로 달성한 사례로 설명하며, 처리 한도를 수십 페이지에서 이른바 무제한으로 끌어올렸다고 밝혔다. 시연에서 모델은 해리 포터 소설 7권, 총 3600페이지 이상을 한 번의 실행으로 읽었고, 문서 길이가 늘어나도 높은 정확도와 처리 속도를 유지했다.
기술적 비결은 팀이 SR-SWA라고 부르는 어텐션 메커니즘이다. 모든 페이지를 한꺼번에 메모리에 담는 대신, 긴 책을 베껴 쓰는 사람처럼 작동한다. 앞을 훑어보며 현재 구절에 중요한 페이지와 정보 블록을 골라내고 나머지는 제쳐둔다. 그런 다음 청크 디코딩 메커니즘이 출력을 조립한다. 바이두에 따르면 이 방식은 100페이지 테스트에서 KV 캐시 최대 사용량을 47기가바이트에서 그 일부로 줄여, 일반 하드웨어에서도 긴 문서를 실용적으로 만들었다.
다중 페이지 문서 분석을 위한 공개 벤치마크에서는 널리 주목받는 M 접두사 테스트를 포함해 모델이 최첨단 결과를 달성했다고 회사는 밝혔다. 바이두는 이번 공개를 OCR 3.0 시대의 도래로 규정한다. 문서 분석이 한 페이지를 얼마나 잘 읽는지가 아니라 전체 아카이브를 얼마나 안정적으로 처리하는지로 평가받는 시대다.
실질적 stakes는 크다. 계약서, 법원 기록, 의료 기록, 역사 아카이브, 학술 도서관은 모두 스캔한 페이지 더미로 존재한다. 이를 한 번에 처리할 수 있는 모델은 법률 사무소, 병원, 출판사가 백로그를 디지털화하는 방식을 바꿀 수 있다. 또한 수백 페이지에 걸쳐 추론하라는 요청에 컨텍스트 창과 검색으로 어려움을 겪어온 AI 어시스턴트에 긴 문서를 직접 공급할 수도 있다.
오픈소스화는 클라우드 제공업체에 페이지당 요금을 내지 않고 문서 도구를 만들려는 개발자의 진입 장벽을 낮춘다. 바이두는 Wenxin 제품군을 자사 제품과 외부 개발자 모두의 기반으로 자리매김해 왔으며, OCR 모델을 무료로 공개하는 것은 이 전략에 부합한다.
무제한 페이지 주장은 검증을 부를 것이다. 독립적인 테스트는 깨끗한 책 페이지뿐 아니라 지저분한 실제 스캔, 필기, 표에서도 정확도가 유지되는지 확인해야 한다. 그래도 시연은 인상적이다. 단일 모델이 7권 시리즈 전체를 한 번에 읽는 것은 기억에 남기 쉬운 구체적인 벤치마크다.
전 세계 독자에게 이번 공개는 중국의 AI 연구소들이 화제성 모델 크기뿐 아니라 실용적 엔지니어링에서도 치열하게 경쟁하고 있음을 상기시킨다. 문서 분석은 화려하지 않은 작업이지만 기업 AI 도입의 상당 부분을 떠받치고 있다. 모델이 광고대로 작동한다면, 다음 격전지는 긴 문서 이해를 누가 먼저 일상적인 사무 도구로 바꾸는가가 될 것이다.