Baidu'nun yeni OCR modeli yedi Harry Potter kitabını birden okuyor
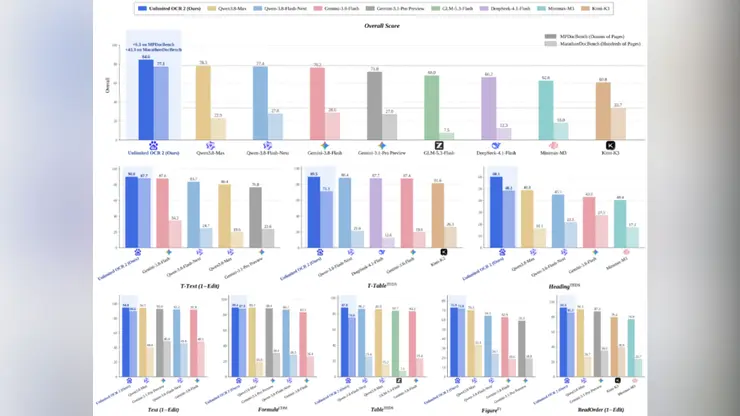
Metin görüntülerini düzenlenebilir kelimelere dönüştüren optik karakter tanıma teknolojisinin uzun süredir bir tavanı var. Çoğu sistem, doğruluk düşmeden veya bellek kullanımı patlamadan önce birkaç düzine sayfayla baş edebiliyor. Baidu, 27 Ekim’de Wenxin Unlimited OCR 2 adını verdiği ve bu sınırı tamamen ortadan kaldırdığını söylediği modeli yayımladı ve açık kaynak yaptı.
Şirket, yayımı herhangi bir sayıda sayfayla belge ayrıştırmaya ulaşan ilk model olarak tanımlıyor ve işleme tavanını birkaç düzine sayfadan sınırsız dediği noktaya taşıyor. Bir gösterimde model, yedi Harry Potter romanının tamamını tek seferde okudu; toplamda 3.600’den fazla sayfa olan bu belgede uzunluk arttıkça yüksek doğruluk ve işlem hızını korudu.
Teknik hile, ekibin SR-SWA adını verdiği bir dikkat mekanizması. Model her sayfayı aynı anda bellekte tutmak yerine uzun bir kitabı kopyalayan bir insan gibi çalışıyor: ileriye bakıyor, mevcut pasaj için önemli olan sayfaları ve bilgi bloklarını seçiyor, gerisini bir kenara bırakıyor. Ardından parçalı bir kod çözme mekanizması çıktıyı bir araya getiriyor. Baidu, bu yaklaşımın yüz sayfalık bir testte en yüksek KV önbellek kullanımını 47 gigabayttan bunun küçük bir bölümüne indirdiğini ve uzun belgeleri sıradan donanımda uygulanabilir kıldığını söylüyor.
Şirkete göre, çok sayfalı belge ayrıştırma için kamuya açık kıyaslamalar, aralarında yakından izlenen M önekli testler de dahil, modelin en son teknoloji sonuçlarına ulaştığını gösteriyor. Baidu, yayımı bir OCR 3.0 döneminin gelişi olarak sunuyor; bu dönemde belge ayrıştırma, bir modelin tek bir sayfayı ne kadar iyi okuduğuyla değil, bütün bir arşivi ne kadar güvenilir işlediğiyle değerlendiriliyor.
Pratikteki risk büyük. Sözleşmeler, mahkeme dosyaları, tıbbi kayıtlar, tarihi arşivler ve akademik kütüphanelerin hepsi taranmış sayfa yığınları olarak geliyor. Bunları tek seferde alabilen bir model, hukuk bürolarının, hastanelerin ve yayıncıların birikmiş işlerini dijitalleştirme biçimini değiştirebilir. Ayrıca uzun belgeleri doğrudan yapay zeka asistanlarına besleyebilir; bu asistanlar yüzlerce sayfa üzerinde akıl yürütmeleri istendiğinde bağlam pencereleri ve geri getirme konusunda zorlanıyor.
Modelin açık kaynak yapılması, bulut sağlayıcısına sayfa başına ücret ödemeden belge araçları geliştirmek isteyenler için eşiği düşürüyor. Baidu, Wenxin ailesini hem kendi ürünleri hem de dış geliştiriciler için bir temel olarak konumlandırıyor ve OCR modelini ücretsiz yayımlamak bu stratejiye uyuyor.
Sınırsız sayfa iddiası dikkatle incelenecek. Bağımsız testlerin, doğruluğun yalnızca temiz kitap sayfalarında değil, dağınık gerçek dünya taramalarında, el yazısında ve tablolarda da korunduğunu doğrulaması gerekecek. Yine de demo çarpıcı: tek bir modelin yedi kitaplık bir dizinin tamamını bir çırpıda okuması, akılda kalan türden somut bir kıyaslama.
Küresel okuyucular için bu yayım, Çin’in yapay zeka laboratuvarlarının manşetlik model boyutlarının yanı sıra pratik mühendislikte de sert rekabet ettiğini hatırlatıyor. Belge ayrıştırma gösterişsiz bir iş, ama kurumsal yapay zeka benimsemesinin büyük bir bölümünün altında yatıyor. Model tanıtıldığı gibi çalışırsa, bir sonraki savaş alanı uzun belge anlayışını ilk kez günlük ofis araçlarına dönüştürenin kim olacağı olacak.