Model OCR Baru Baidu Mampu Membaca Ketujuh Buku Harry Potter Sekaligus
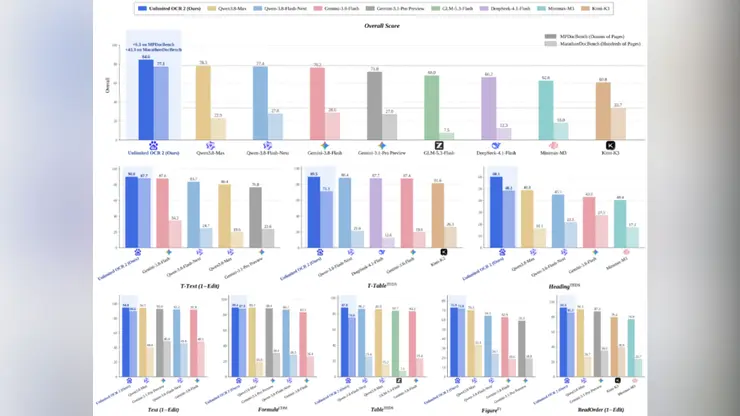
Optical character recognition, teknologi yang mengubah gambar teks menjadi kata-kata yang bisa diedit, selama ini memiliki batas. Sebagian besar sistem hanya sanggup menangani beberapa lusin halaman sebelum akurasi menurun atau penggunaan memori melonjak. Pada 27 Oktober, Baidu merilis dan membuka kode sumber model bernama Wenxin Unlimited OCR 2, yang diklaim menghapus batas itu sepenuhnya.
Perusahaan menyebut rilis ini sebagai yang pertama kalinya sebuah model mencapai penguraian dokumen dengan jumlah halaman arbitrer, mendorong batas pemrosesan dari puluhan halaman menuju apa yang mereka sebut tak terbatas. Dalam sebuah demonstrasi, model tersebut membaca ketujuh novel Harry Potter dalam satu kali proses, totalnya lebih dari 3.600 halaman, sambil mempertahankan akurasi dan kecepatan pemrosesan yang tinggi seiring bertambahnya panjang dokumen.
Trik teknisnya adalah mekanisme atensi yang oleh tim disebut SR-SWA. Alih-alih menyimpan setiap halaman di memori sekaligus, model bekerja seperti orang yang menyalin buku tebal: ia memindai ke depan, memilih halaman dan blok informasi yang relevan untuk bagian yang sedang diproses, lalu menyisihkan sisanya. Mekanisme dekode terpotong kemudian merakit keluarannya. Baidu menyatakan pendekatan ini menurunkan penggunaan puncak cache KV dalam uji seratus halaman dari 47 gigabyte menjadi sebagian kecil dari angka itu, sehingga dokumen panjang menjadi praktis di perangkat keras biasa.
Menurut perusahaan, tolok ukur publik untuk penguraian dokumen multi-halaman, termasuk uji berawalan M yang banyak diperhatikan, menunjukkan model ini mencapai hasil terbaik di kelasnya. Baidu membingkai rilis ini sebagai datangnya era OCR 3.0, di mana penguraian dokumen dinilai bukan dari seberapa baik model membaca satu halaman, melainkan dari seberapa andal ia menangani seluruh arsip.
Taruhannya besar. Kontrak, berkas pengadilan, rekam medis, arsip sejarah, dan perpustakaan akademik semuanya datang sebagai tumpukan halaman pindaian. Model yang dapat menyerapnya dalam satu kali proses bisa mengubah cara firma hukum, rumah sakit, dan penerbit mendigitalkan tumpukan dokumen mereka. Model ini juga bisa langsung memasok dokumen panjang ke asisten AI, yang selama ini kesulitan dengan jendela konteks dan pengambilan informasi saat diminta bernalar atas ratusan halaman.
Membuka kode sumber model ini menurunkan hambatan bagi pengembang yang ingin membangun alat dokumen tanpa membayar biaya per halaman ke penyedia cloud. Baidu telah memosisikan keluarga Wenxin sebagai fondasi bagi produknya sendiri maupun pengembang eksternal, dan merilis model OCR ini secara gratis sejalan dengan strategi tersebut.
Klaim halaman tak terbatas tentu akan mengundang pengujian. Uji independen perlu memastikan akurasi tetap terjaga pada pindaian dunia nyata yang berantakan, tulisan tangan, dan tabel, bukan hanya halaman buku yang bersih. Meski begitu, demonya mencolok: satu model membaca seluruh seri tujuh buku dalam sekali jalan adalah tolok ukur konkret yang cenderung melekat.
Bagi pembaca global, rilis ini menjadi pengingat bahwa laboratorium AI Tiongkok bersaing keras dalam rekayasa praktis maupun ukuran model yang jadi sorotan. Penguraian dokumen adalah pekerjaan yang kurang bergengsi, tetapi mendasari sebagian besar adopsi AI di perusahaan. Jika model ini berperforma sesuai klaim, medan pertempuran berikutnya adalah siapa yang lebih dulu mengubah pemahaman dokumen panjang menjadi alat kantor sehari-hari.