बैदु का नया OCR मॉडल एक साथ पढ़ता है हैरी पॉटर की सातों किताबें
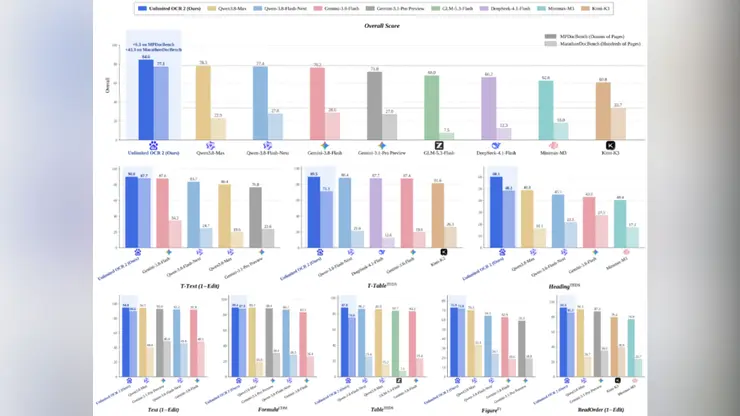
ऑप्टिकल कैरेक्टर रिकग्निशन, यानी टेक्स्ट की तस्वीरों को संपादन योग्य शब्दों में बदलने वाली तकनीक, की एक सीमा लंबे समय से रही है। ज़्यादातर सिस्टम कुछ दर्जन पृष्ठों तक ही काम कर पाते हैं, उसके बाद सटीकता गिरने लगती है या मेमोरी का उपयोग बढ़ जाता है। 27 अक्टूबर को बैदु ने Wenxin Unlimited OCR 2 नाम का मॉडल जारी किया और ओपन-सोर्स किया, जिसके बारे में कंपनी का दावा है कि यह इस सीमा को पूरी तरह हटा देता है।
कंपनी इस रिलीज़ को किसी भी मॉडल द्वारा पहली बार मनमाने पृष्ठों वाले दस्तावेज़ पार्सिंग हासिल करने के रूप में बताती है, जो प्रोसेसिंग की सीमा को कुछ दर्जन पृष्ठों से उस तक ले जाता है जिसे वह असीमित कहती है। एक प्रदर्शन में मॉडल ने हैरी पॉटर के सातों उपन्यास एक ही रन में पढ़े, कुल मिलाकर 3,600 से अधिक पृष्ठ, और दस्तावेज़ की लंबाई बढ़ने के साथ-साथ उच्च सटीकता और प्रोसेसिंग गति बनाए रखी।
तकनीकी चाल एक अटेंशन मेकैनिज़्म है जिसे टीम SR-SWA कहती है। हर पृष्ठ को एक साथ मेमोरी में रखने के बजाय, मॉडल वैसे काम करता है जैसे कोई व्यक्ति लंबी किताब की नकल करते समय करता है: वह आगे देखता है, वर्तमान अंश के लिए महत्वपूर्ण पृष्ठों और सूचना ब्लॉकों का चयन करता है और बाकी को एक तरफ रख देता है। फिर एक चंक्ड डिकोडिंग मेकैनिज़्म आउटपुट को जोड़ता है। बैदु का कहना है कि इस दृष्टिकोण ने सौ पृष्ठों के एक परीक्षण में शिखर KV कैश उपयोग को 47 गीगाबाइट से उसके एक छोटे अंश तक घटा दिया, जिससे लंबे दस्तावेज़ सामान्य हार्डवेयर पर व्यावहारिक हो गए।
कंपनी के अनुसार, बहु-पृष्ठ दस्तावेज़ पार्सिंग के सार्वजनिक बेंचमार्क, जिनमें व्यापक रूप से देखे जाने वाले M-उपसर्ग वाले परीक्षण भी शामिल हैं, दर्शाते हैं कि मॉडल अत्याधुनिक परिणाम प्राप्त कर रहा है। बैदु इस रिलीज़ को OCR 3.0 युग के आगमन के रूप में प्रस्तुत कर रहा है, जिसमें दस्तावेज़ पार्सिंग का मूल्यांकन इस बात से नहीं होता कि कोई मॉडल एक पृष्ठ कितना अच्छा पढ़ता है, बल्कि इस बात से होता है कि वह पूरे संग्रह को कितनी विश्वसनीयता से संभालता है।
व्यावहारिक दांव बड़ा है। अनुबंध, अदालती फ़ाइलें, चिकित्सा रिकॉर्ड, ऐतिहासिक अभिलेखागार और शैक्षणिक पुस्तकालय सभी स्कैन किए गए पृष्ठों के ढेर के रूप में आते हैं। एक ऐसा मॉडल जो उन्हें एक ही बार में ग्रहण कर सके, यह बदल सकता है कि लॉ फर्म, अस्पताल और प्रकाशक अपने बैकलॉग को कैसे डिजिटल करते हैं। यह लंबे दस्तावेज़ों को सीधे AI सहायकों में भी डाल सकता है, जो सैकड़ों पृष्ठों पर तर्क करने के लिए कहे जाने पर कॉन्टेक्स्ट विंडो और रिट्रीवल से जूझते रहे हैं।
मॉडल को ओपन-सोर्स करने से उन डेवलपर्स के लिए बाधा कम होती है जो क्लाउड प्रदाता को प्रति-पृष्ठ शुल्क दिए बिना दस्तावेज़ उपकरण बनाना चाहते हैं। बैदु अपने Wenxin परिवार को अपने उत्पादों और बाहरी डेवलपर्स दोनों के लिए आधार के रूप में स्थापित कर रहा है, और OCR मॉडल को मुफ़्त जारी करना उसी रणनीति में फिट बैठता है।
असीमित पृष्ठों का दावा जांच को आमंत्रित करेगा। स्वतंत्र परीक्षणों को यह पुष्टि करनी होगी कि सटीकता गंदे वास्तविक-दुनिया के स्कैन, हस्तलेखन और तालिकाओं पर बनी रहती है, न कि केवल साफ़ किताबी पृष्ठों पर। फिर भी, डेमो प्रभावशाली है: एक ही मॉडल का पूरी सात-पुस्तक श्रृंखला को एक बार में पढ़ना उस तरह का ठोस बेंचमार्क है जो याद रह जाता है।
वैश्विक पाठकों के लिए, यह रिलीज़ एक अनुस्मारक है कि चीन की AI प्रयोगशालाएं सुर्खियों वाले मॉडल आकारों के साथ-साथ व्यावहारिक इंजीनियरिंग पर भी कड़ी प्रतिस्पर्धा कर रही हैं। दस्तावेज़ पार्सिंग बिना चमक-दमक वाला काम है, लेकिन एंटरप्राइज़ AI अपनाने का एक बड़ा हिस्सा इसी पर टिका है। अगर मॉडल वैसा प्रदर्शन करता है जैसा विज्ञापित है, तो अगला युद्धक्षेत्र यह होगा कि लंबे दस्तावेज़ों की समझ को सबसे पहले रोज़मर्रा के ऑफ़िस उपकरणों में कौन बदलता है।