टेनसेंट ने ऐसा सिमल्टेनियस इंटरप्रेटर ओपन-सोर्स किया जो इंसानी लेटेंसी को पछाड़ता है
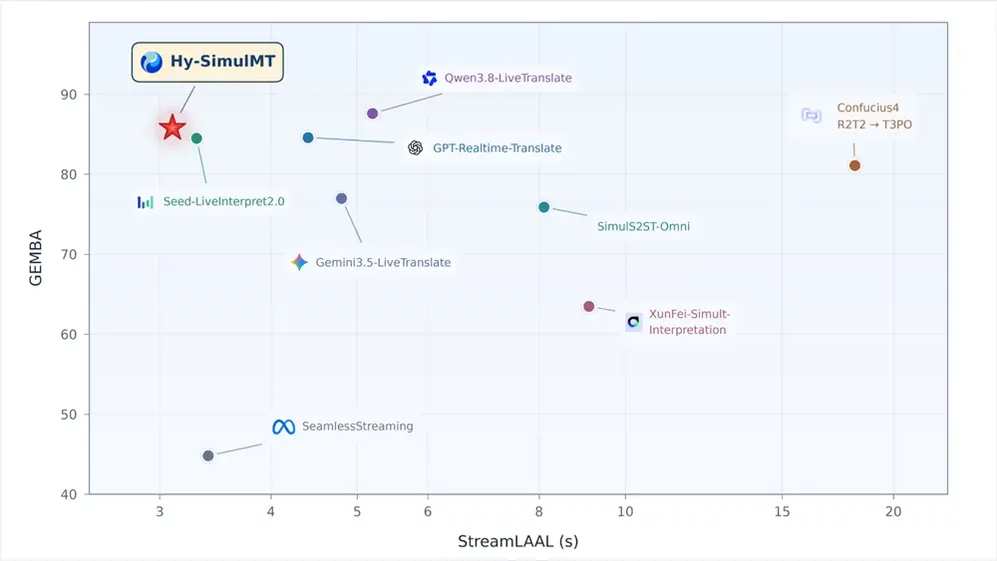
टेनसेंट की हुनयुआन शोध टीम ने 26 अक्टूबर को Hy-SimulMT नाम का एक सिमल्टेनियस अनुवाद मॉडल जारी किया और ओपन-सोर्स किया, जो उस तरह की लाइव दुभाषिया के लिए बनाया गया है जिसके लिए आम तौर पर साउंडप्रूफ बूथ में प्रशिक्षित इंसान की ज़रूरत होती है। मॉडल वक्ता का ऑडियो लेता है और वक्ता के अभी बोलते रहते हुए अनुवादित भाषण देता है, पूरा वाक्य खत्म होने का इंतज़ार किए बिना चीनी और अंग्रेज़ी के बीच दोनों दिशाओं में बदलता है।
सबसे चर्चित आँकड़ा लेटेंसी का है। टेनसेंट का कहना है कि सिस्टम लगभग तीन सेकंड में जवाब देता है, जबकि पेशेवर इंसानी सिमल्टेनियस दुभाषियों के लिए औसत चार से पाँच सेकंड है। सिमल्टेनियस काम में ये सेकंड ही सब कुछ हैं: जितनी देर देरी, उतना ही दर्शक धागा खोते हैं और वक्ता व दुभाषिए के लिए तालमेल बनाए रखना उतना ही मुश्किल होता है। कंपनी यह भी दावा करती है कि कई मूल्यांकनों में इसकी अनुवाद गुणवत्ता इंसानी कॉन्फ्रेंस दुभाषियों के स्तर तक पहुँचती है, जो मुख्यधारा के ओपन-सोर्स मॉडलों और ज़्यादातर व्यावसायिक API से आगे है।
अनुवाद जगत के बाहर सबसे ज़्यादा ध्यान खींचने वाली सुविधा रीयल-टाइम टिम्बर क्लोनिंग है। Hy-SimulMT आउटपुट ऑडियो में वक्ता की आवाज़ और लहजे को दोहराता है, इसलिए चीनी बोलने वाले किसी व्यक्ति की अंग्रेज़ी उसी व्यक्ति जैसी सुनाई देती है, किसी सामान्य सिंथेटिक आवाज़ जैसी नहीं। यह मीटिंग, लाइवस्ट्रीम और यात्रा के लिए एक अर्थपूर्ण कदम है, लेकिन यह आवाज़ डेटा और सहमति पर वे परिचित सवाल भी उठाता है जो क्लोनिंग में सक्षम हर सिस्टम के साथ आते हैं।
टेनसेंट ने मॉडल को अपने Hy अनुवाद ऐप में मुफ़्त पहली झलक के तौर पर डाला है, और कोड व वेट्स HuggingFace, ModelScope और GitHub पर उपलब्ध हैं। मॉडल को API के पीछे रखने के बजाय खोलना अब चीनी AI लैबों में आम एक पैटर्न का पालन करता है, जो अक्सर डेवलपर इकोसिस्टम और विश्वसनीयता बनाने के लिए ओपन रिलीज़ का इस्तेमाल करते हैं जबकि व्यावसायिक प्रतिद्वंद्वी अपने सबसे अच्छे सिस्टम बंद रखते हैं।
सिमल्टेनियस दुभाषिया अब एक भीड़भाड़ वाला मोर्चा बन गया है। यह समस्या AI के लिए अच्छी तरह फिट बैठती है क्योंकि यह कम लेटेंसी, स्थिर आउटपुट और अव्यवस्थित, एक-दूसरे पर चढ़ते भाषण को संभालने की क्षमता को पुरस्कृत करती है, और ये सभी ऐसे क्षेत्र हैं जहाँ बड़े स्पीच मॉडल तेज़ी से बेहतर हुए हैं। यह उन गिने-चुने AI कामों में से भी है जिनका स्पष्ट, मापने योग्य इंसानी बेंचमार्क है: पेशेवर दुभाषिए, जिनकी गति और सटीकता हर किसी के समझ में आने वाला पैमाना देती है।
वैश्विक दर्शकों के लिए व्यावहारिक असर दुभाषियों को बदलने से कम, पहुँच बढ़ाने से ज़्यादा है। फ़ोन पर चलने वाली तीन सेकंड की स्पीच-टू-स्पीच पाइपलाइन किसी सेवा को बुक किए बिना भाषा की बाधा पार करते हुए बिज़नेस कॉल, फैक्ट्री का दौरा या अस्पताल की बातचीत संभव बना सकती है। आवाज़-क्लोनिंग की परत अनुभव को कम यांत्रिक बनाती है, हालाँकि इसका मतलब यह भी है कि तकनीक किसी व्यक्ति के भाषण की नकल ऐसी भाषा में कर सकती है जो वह नहीं बोलता।
अगली परीक्षा असली दुनिया में इस्तेमाल है। ऐप समीक्षाएँ और ओपन वेट्स पर बने डेवलपर प्रोजेक्ट दिखाएँगे कि तीन सेकंड का जवाब शोरगुल वाले ऑडियो, भारी लहजों और तकनीकी शब्दावली पर टिकता है या नहीं, जहाँ लैब मूल्यांकन किसी मॉडल को अक्सर बढ़ा-चढ़ाकर दिखाते हैं। टेनसेंट के इस कदम ने प्रतिद्वंद्वियों पर तुलनीय लेटेंसी आँकड़े प्रकाशित करने का दबाव भी डाला है, जिससे खरीदारों को ऐसे बाज़ार को परखने का साफ़ तरीका मिलेगा जो अब तक ज़्यादातर डेमो वीडियो पर चला है।