تينسنت تفتح المصدر لمترجم فوري يتفوق على البشر في زمن الاستجابة
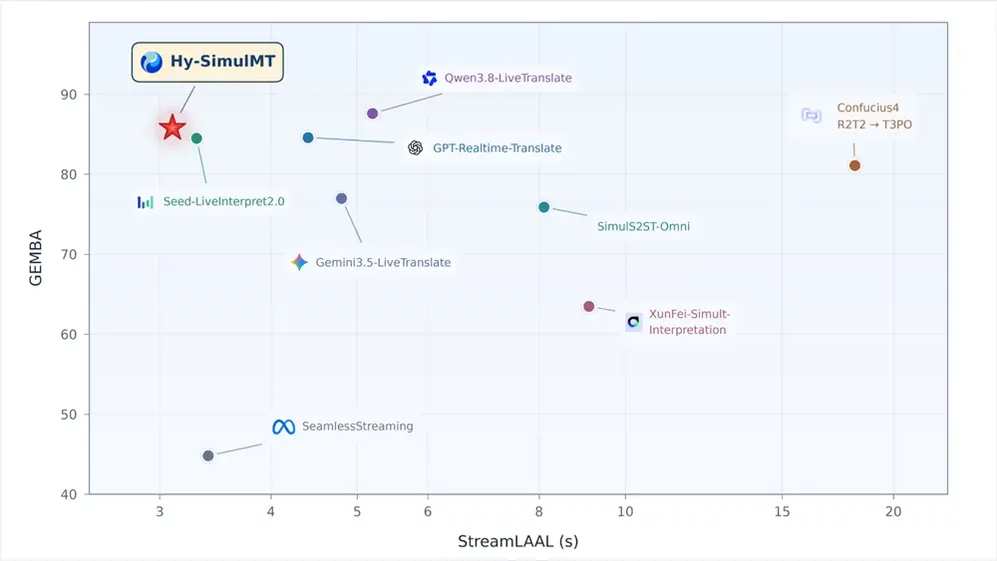
أصدر فريق أبحاث Hunyuan في تينسنت في 26 أكتوبر نموذج ترجمة فورية يُدعى Hy-SimulMT وفتح مصدره، وهو مصمم لنوع الترجمة الشفهية الحية التي تتطلب عادةً مترجمًا مدربًا داخل كابينة عازلة للصوت. يأخذ النموذج صوت المتحدث ويُخرج كلامًا مترجمًا بينما لا يزال المتحدث يتكلم، متنقلًا بين الصينية والإنجليزية في الاتجاهين دون انتظار اكتمال الجملة.
الرقم الأبرز هو زمن الاستجابة. تقول تينسنت إن النظام يستجيب في نحو ثلاث ثوانٍ، مقابل متوسط أربع إلى خمس ثوانٍ لدى المترجمين الفوريين المحترفين. في العمل الفوري، هذه الثواني هي كل شيء: فكلما طال التأخر، فقد الجمهور خيط الحديث، وصار الحفاظ على التزامن بين المتحدث والمترجم أصعب. وتزعم الشركة أيضًا أن جودة ترجمتها تبلغ مستوى مترجمي المؤتمرات البشريين في عدة تقييمات، متقدمة على النماذج المفتوحة السائدة ومعظم واجهات API التجارية.
الميزة التي يُرجَّح أن تجذب أكبر قدر من الاهتمام خارج أوساط الترجمة هي استنساخ نبرة الصوت في الوقت الحقيقي. يعيد Hy-SimulMT إنتاج صوت المتحدث ونبرته في المخرجات الصوتية، فيبدو أداء المتحدث الصيني بالإنجليزية كصوت ذلك الشخص لا كصوت اصطناعي عام. هذه خطوة مهمة للاجتماعات والبث المباشر والسفر، لكنها تثير أيضًا الأسئلة المألوفة حول بيانات الصوت والموافقة التي يستدعيها أي نظام قادر على الاستنساخ.
أدرجت تينسنت النموذج في تطبيق الترجمة Hy لديها كتجربة مجانية أولية، والشيفرة والأوزان متاحة على HuggingFace وModelScope وGitHub. وفتح النموذج بدلًا من إبقائه خلف واجهة API يتبع نمطًا شائعًا الآن بين مختبرات الذكاء الاصطناعي الصينية، التي كثيرًا ما تستخدم الإصدارات المفتوحة لبناء منظومات المطورين والمصداقية بينما تُبقي المنافسات التجارية أفضل أنظمتها مغلقة.
أصبحت الترجمة الفورية جبهة مزدحمة. تناسب المشكلة الذكاء الاصطناعي جيدًا لأنها تكافئ زمن الاستجابة المنخفض والإخراج المستقر والقدرة على التعامل مع كلام فوضوي متداخل، وكلها مجالات تحسنت فيها نماذج الكلام الكبيرة بحدّة. وهي أيضًا من المهام القليلة في الذكاء الاصطناعي ذات معيار بشري واضح وقابل للقياس: المترجمون المحترفون، الذين توفر سرعتهم ودقتهم مقياسًا يفهمه الجميع.
بالنسبة للجماهير العالمية، الأثر العملي أقل ارتباطًا باستبدال المترجمين وأكثر بتوسيع الوصول. فخط ترجمة من الكلام إلى الكلام بثلاث ثوانٍ يعمل على هاتف قد يجعل مكالمة عمل أو جولة في مصنع أو محادثة في مستشفى ممكنة عبر حاجز اللغة دون حجز خدمة. وطبقة استنساخ الصوت تجعل التجربة أقل آلية، وإن كانت تعني أيضًا أن التقنية قادرة على محاكاة كلام شخص بلغة لا يتحدثها.
الاختبار التالي هو الاستخدام الواقعي. ستُظهر مراجعات التطبيق ومشاريع المطورين المبنية على الأوزان المفتوحة ما إذا كانت الاستجابة بثلاث ثوانٍ تصمد أمام الصوت الصاخب واللكنات القوية والمصطلحات التقنية، وهي مجالات تغالي فيها تقييمات المختبرات عادةً في تقدير النموذج. كما تضع خطوة تينسنت ضغطًا على المنافسين لنشر أرقام استجابة قابلة للمقارنة، ما يمنح المشترين طريقة أوضح للحكم على سوق اعتمد حتى الآن في الغالب على فيديوهات العرض.