騰訊開源同聲傳譯模型 延遲表現勝過人類譯員
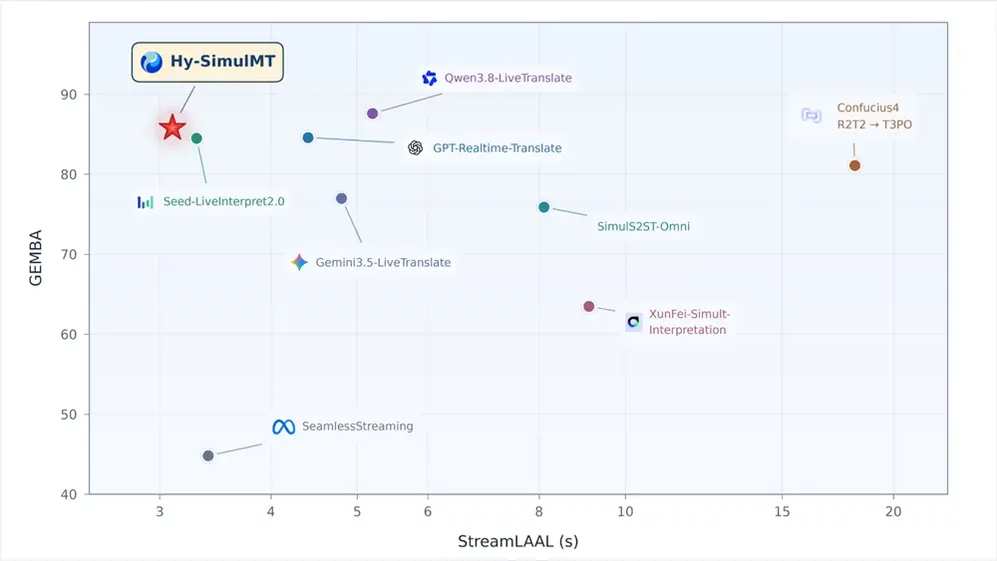
騰訊混元研究團隊於10月26日發布並開源一款名為 Hy-SimulMT 的同聲傳譯模型,針對的正是通常需要受過訓練的人員坐在隔音間裡進行的即時口譯。該模型接收講者的音訊,在講者仍在說話時就輸出翻譯後的語音,中英雙向互譯,無須等整句話說完。
最受矚目的數字是延遲。騰訊稱該系統約三秒即可回應,而專業人類同聲傳譯員平均需要四到五秒。在同聲傳譯中,這幾秒就是關鍵:延遲越長,聽眾越容易跟不上脈絡,講者與譯員也越難保持同步。該公司還宣稱,在多項評測中其翻譯品質達到人類會議口譯員的水準,領先主流開源模型與多數商用 API。
最可能吸引翻譯圈以外目光的功能,是即時音色複製。Hy-SimulMT 在輸出音訊中重現講者的聲音與語調,因此中文講者的英文表達聽起來就像本人,而非千篇一律的合成語音。這對會議、直播與旅遊而言是意義重大的一步,但也引發任何具備複製能力的系統都會招來的常見疑問:語音資料與當事人同意。
騰訊已將該模型放進旗下騰訊翻譯君應用程式,作為免費的搶先體驗,程式碼與權重則可在 HuggingFace、ModelScope 與 GitHub 取得。選擇開源而非藏在 API 之後,符合中國 AI 實驗室如今常見的做法:以開放發布建立開發者生態與公信力,同時商業競爭對手則把最好的系統保持閉源。
同聲傳譯已成擁擠的戰場。這個問題很適合 AI,因為它看重低延遲、穩定輸出,以及處理雜亂、重疊語音的能力,而這些正是大型語音模型近來大幅進步的領域。它也是少數具有明顯、可量測人類基準的 AI 任務之一:專業口譯員的速度與準確度,是任何人都能理解的衡量標準。
對全球受眾而言,實際影響與其說是取代口譯員,不如說是擴大使用機會。一套能在手機上運行的三秒語音轉語音流程,可讓商務通話、工廠導覽或醫院問診跨越語言障礙,無須預約服務。音色複製這一層讓體驗不那麼機械化,但也意味著這項技術能用一個人不會說的語言模仿其說話。
下一道考驗是實際應用。應用程式評價與開發者以開源權重打造的專案,將顯示三秒回應在吵雜音訊、濃重口音與專業術語下是否站得住腳,而這些正是實驗室評測往往對模型過於寬容的地方。騰訊此舉也對競爭對手形成壓力,迫使其公布可相比的延遲數據,讓買方能更清楚地評判這個至今多半靠示範影片運作的市場。