Tencent Rilis Model Penerjemah Simultan Open-Source yang Lebih Cepat dari Juru Bahasa Manusia
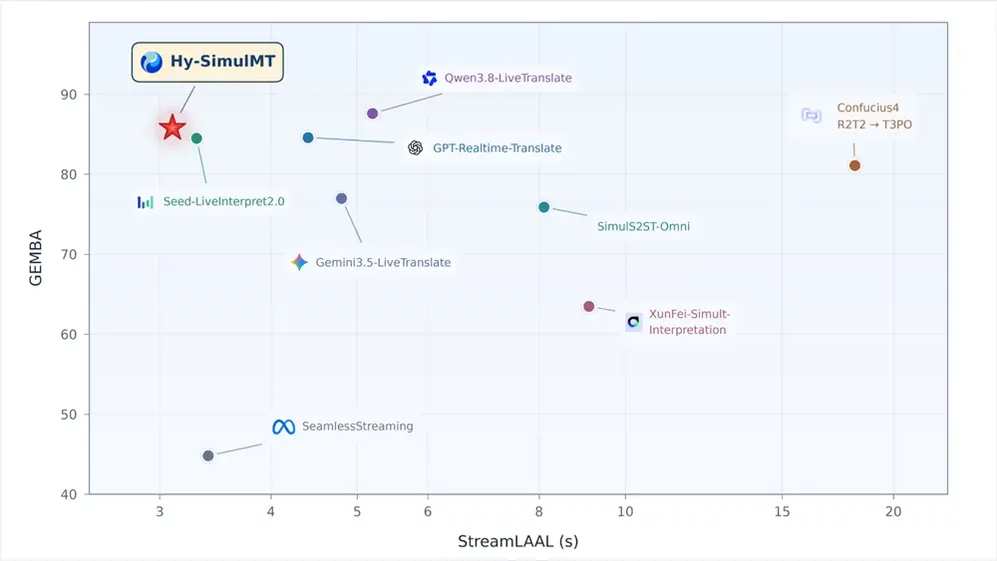
Tim riset Hunyuan Tencent merilis dan membuka kode sumber model terjemahan simultan bernama Hy-SimulMT pada 26 Oktober, dirancang untuk interpretasi langsung yang biasanya membutuhkan juru bahasa terlatih di bilik kedap suara. Model ini menerima audio dari pembicara dan mengeluarkan suara terjemahan saat pembicara masih berbicara, berpindah antara bahasa Mandarin dan Inggris dalam dua arah tanpa menunggu satu kalimat selesai.
Angka utamanya adalah latensi. Tencent menyebut sistem ini merespons dalam sekitar tiga detik, dibandingkan rata-rata empat hingga lima detik bagi juru bahasa simultan profesional. Dalam kerja simultan, selisih detik itu menentukan segalanya: semakin panjang jeda, semakin audiens kehilangan alur, dan semakin sulit pembicara serta juru bahasa tetap sinkron. Perusahaan juga mengklaim kualitas terjemahannya mencapai level juru bahasa konferensi manusia pada sejumlah evaluasi, melampaui model open-source arus utama dan sebagian besar API komersial.
Fitur yang kemungkinan paling menarik perhatian di luar kalangan penerjemahan adalah kloning timbre secara real time. Hy-SimulMT mereproduksi suara dan nada pembicara pada audio keluaran, sehingga penyampaian bahasa Inggris dari pembicara berbahasa Mandarin terdengar seperti orang tersebut, bukan suara sintetis generik. Ini langkah berarti bagi rapat, siaran langsung, dan perjalanan, tetapi juga memunculkan pertanyaan lazim soal data suara dan persetujuan yang melekat pada sistem apa pun yang mampu mengkloning.
Tencent telah menempatkan model ini di aplikasi terjemahan Hy miliknya sebagai pengalaman uji coba gratis, dan kode serta bobotnya tersedia di HuggingFace, ModelScope, dan GitHub. Membuka model alih-alih menyimpannya di balik API mengikuti pola yang kini umum di antara laboratorium AI Tiongkok, yang kerap memakai rilis terbuka untuk membangun ekosistem pengembang dan kredibilitas sementara pesaing komersial menutup sistem terbaik mereka.
Interpretasi simultan telah menjadi medan yang padat. Masalah ini cocok untuk AI karena menuntut latensi rendah, keluaran stabil, dan kemampuan menangani ucapan yang berantakan dan saling tumpang tindih, semua area tempat model suara besar telah meningkat tajam. Ini juga salah satu dari sedikit tugas AI dengan tolok ukur manusia yang jelas dan terukur: juru bahasa profesional, yang kecepatan dan akurasinya menjadi patokan yang mudah dipahami siapa pun.
Bagi audiens global, efek praktisnya bukan soal menggantikan juru bahasa, melainkan memperluas akses. Pipeline suara-ke-suara tiga detik yang berjalan di ponsel dapat memungkinkan panggilan bisnis, penelusuran pabrik, atau percakapan di rumah sakit melintasi hambatan bahasa tanpa memesan layanan. Lapisan kloning suara membuat pengalaman terasa kurang mekanis, meski juga berarti teknologi ini dapat meniru ucapan seseorang dalam bahasa yang tidak ia kuasai.
Ujian berikutnya adalah penggunaan di dunia nyata. Ulasan aplikasi dan proyek pengembang yang dibangun di atas bobot terbuka akan menunjukkan apakah respons tiga detik itu bertahan pada audio bising, aksen kuat, dan kosakata teknis, area yang cenderung dimanjakan evaluasi laboratorium. Langkah Tencent juga menekan pesaing untuk menerbitkan angka latensi yang sebanding, yang akan memberi pembeli cara lebih jelas menilai pasar yang sejauh ini sebagian besar berjalan lewat video demo.