テンセント、人間の遅延を上回る同時通訳モデルをオープンソース化
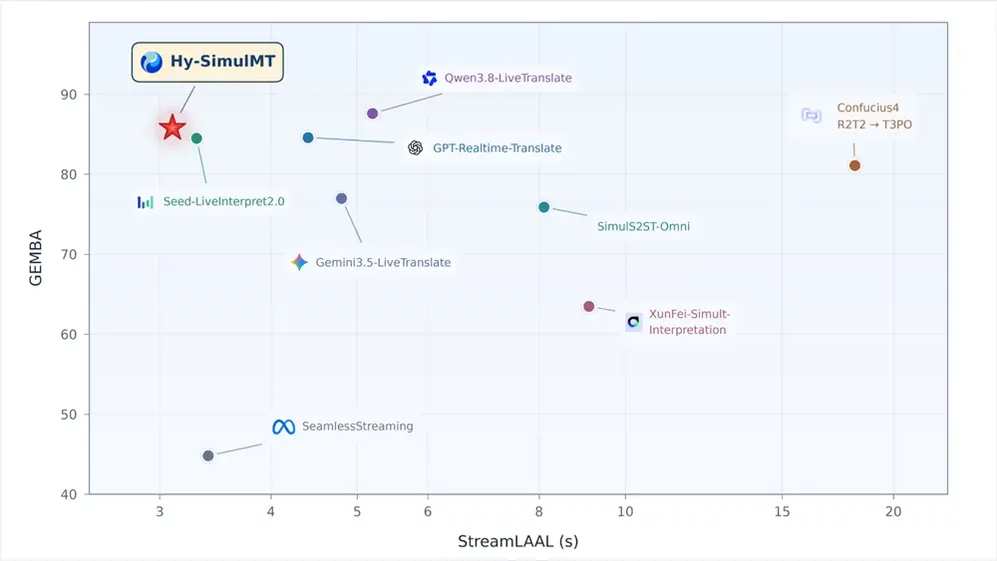
テンセントの混元(Hunyuan)研究チームは10月26日、同時通訳モデル「Hy-SimulMT」を公開し、オープンソース化した。防音ブースに入った訓練済みの人間を通常必要とする同時通訳向けに作られたものだ。このモデルは話者の音声を入力として受け取り、話者がまだ話している間に翻訳音声を出力する。文が終わるのを待たずに、中国語と英語の間を双方向に切り替える。
注目すべき数字は遅延だ。テンセントによれば、システムの応答は約3秒で、プロの同時通訳者の平均4〜5秒を下回る。同時通訳ではこの数秒がすべてを決める。遅れが大きいほど聴衆は話の筋を見失い、話者と通訳者が同期を保つのも難しくなる。同社はまた、複数の評価で翻訳品質が人間の会議通訳者の水準に達し、主流のオープンソースモデルやほとんどの商用APIを上回ると主張している。
翻訳業界の外で最も注目を集めそうな機能は、リアルタイムの音色クローンだ。Hy-SimulMTは出力音声で話者の声と抑揚を再現するため、中国語話者の英語は汎用の合成音声ではなく、その人自身のように聞こえる。会議やライブ配信、旅行にとって大きな前進だが、クローン化が可能なシステムが常に招く、音声データと同意に関するおなじみの疑問も提起する。
テンセントはこのモデルを翻訳アプリ「Hy」に無料の先行体験として組み込み、コードと重みはHuggingFace、ModelScope、GitHubで公開している。APIの背後に囲い込まずにモデルを公開するのは、中国のAIラボで今や一般的なパターンだ。開発者エコシステムと信頼を築くためにオープンな公開をよく利用する一方、商用の競合他社は最高のシステムを非公開にしている。
同時通訳は競争の激しい最前線となった。この問題はAIに向いており、低遅延、安定した出力、乱雑で重なり合う音声への対応力が評価される。いずれも大規模音声モデルが急激に改善してきた分野だ。また、明らかで測定可能な人間の基準を持つ数少ないAIタスクの一つでもある。プロの通訳者の速度と正確さは、誰にでも分かる物差しになる。
世界の利用者にとって実際の効果は、通訳者の置き換えよりもアクセスの拡大にある。スマートフォンで動く3秒の音声-to-音声パイプラインがあれば、サービスを予約しなくても、言語の壁を越えて商談や工場見学、病院での会話が可能になる。音声クローン層は体験を機械的に感じさせにくくするが、話者が話せない言語でその人の話し方を模倣できることも意味する。
次の試練は実世界での利用だ。アプリのレビューやオープンな重みを使った開発者プロジェクトは、3秒の応答が騒がしい音声、強いなまり、専門用語でも持ちこたえるかを示す。こうした場面では研究室の評価はモデルに甘くなりがちだ。テンセントの動きは、比較可能な遅延の数字を公開するよう競合他社を促す圧力にもなる。そうなれば、これまで主にデモ動画で動いてきた市場を買い手がより明確に判断できるようになる。