Baiduの新OCRモデル、ハリー・ポッター全7巻を一度に読む
テキストの画像を編集可能な文字に変換する技術、光学文字認識(OCR)には長らく限界があった。ほとんどのシステムは数十ページを処理すると精度が落ちたり、メモリ使用量が急増したりする。10月27日、Baiduは「Wenxin Unlimited OCR 2」と呼ぶモデルを公開し、オープンソース化した。同社によれば、この限界を完全に取り除いたという。
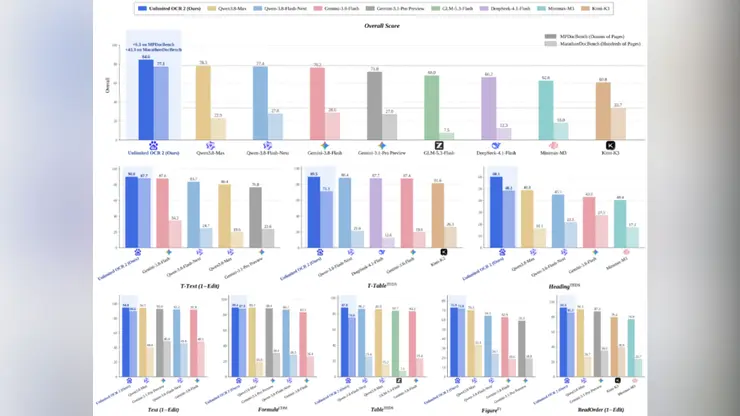
同社はこのリリースを、任意のページ数の文書解析をモデルが初めて実現したものと位置づけ、処理の上限を数十ページから「無制限」へと引き上げたと説明する。デモでは、モデルはハリー・ポッター全7巻、合計3600ページ以上を1回の実行で読み込み、文書の長さが増えても高い精度と処理速度を維持した。
技術的な仕掛けは、チームがSR-SWAと呼ぶアテンション機構だ。すべてのページを一度にメモリに保持するのではなく、長い本を書き写す人のように動作する。先を読み、現在の箇所に関係するページや情報ブロックを選び、それ以外は脇に置く。その後、チャンク化されたデコーディング機構が出力を組み立てる。Baiduによれば、この手法により100ページのテストでのKVキャッシュのピーク使用量は47ギガバイトからそのごく一部に削減され、長い文書が一般的なハードウェアでも実用的になった。
多ページ文書解析の公開ベンチマークでは、広く注目されるM接頭辞のテストを含め、モデルは最先端の結果を達成していると同社は述べる。Baiduはこのリリースを、文書解析が1ページをどれだけうまく読むかではなく、アーカイブ全体をどれだけ確実に扱えるかで評価されるOCR 3.0時代の到来と位置づけている。
実用的な意味は大きい。契約書、裁判記録、医療記録、歴史的アーカイブ、学術図書館は、すべてスキャンされたページの山として存在する。それらを1回の処理で取り込めるモデルは、法律事務所や病院、出版社のバックログのデジタル化を変えうる。また、数百ページにわたる推論を求められるとコンテキストウィンドウや検索で苦労してきたAIアシスタントに、長い文書を直接供給することも可能になる。
オープンソース化は、クラウドプロバイダーにページ単位の料金を払わずに文書ツールを構築したい開発者の障壁を下げる。BaiduはWenxinファミリーを自社製品と外部開発者の両方の基盤として位置づけており、OCRモデルを無償公開することはこの戦略に合致する。
無制限ページという主張は精査を招くだろう。独立したテストで、きれいな本のページだけでなく、乱雑な実世界のスキャンや手書き、表でも精度が保たれることを確認する必要がある。それでも、1つのモデルが7巻シリーズ全体を一度に読むというデモは印象的だ。記憶に残りやすい具体的なベンチマークの一つである。
世界の読者にとって、このリリースは中国のAI研究所が目立つモデルサイズだけでなく、実用的なエンジニアリングでも激しく競争していることを思い起こさせる。文書解析は地味な作業だが、企業のAI導入の大部分を支えている。モデルが宣伝通りに動作すれば、次の戦場は長文書理解をいち早く日常のオフィスツールに変えるのは誰かになる。