Mô hình OCR mới của Baidu đọc trọn bảy tập Harry Potter trong một lần
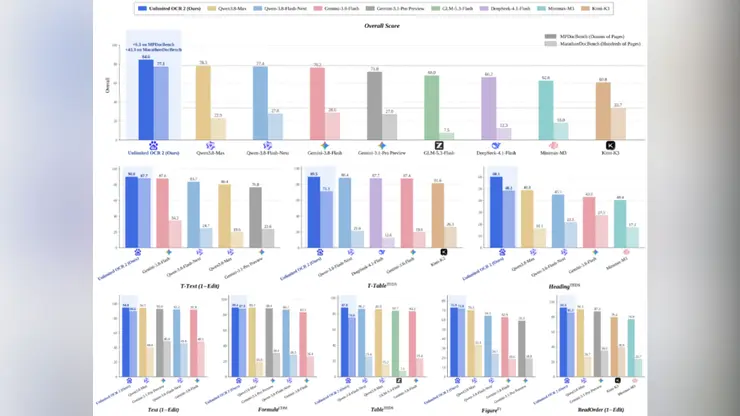
Nhận dạng ký tự quang học, công nghệ biến hình ảnh văn bản thành chữ có thể chỉnh sửa, từ lâu đã có giới hạn. Hầu hết hệ thống chỉ xử lý được vài chục trang trước khi độ chính xác giảm hoặc bộ nhớ phình to. Ngày 27 tháng 10, Baidu đã phát hành và mã nguồn mở mô hình mang tên Wenxin Unlimited OCR 2, mà hãng nói đã xóa bỏ hoàn toàn giới hạn đó.
Công ty mô tả đây là lần đầu tiên một mô hình đạt được khả năng phân tích tài liệu với số trang tùy ý, đẩy giới hạn xử lý từ vài chục trang lên mức mà họ gọi là không giới hạn. Trong một buổi trình diễn, mô hình đọc trọn bảy cuốn tiểu thuyết Harry Potter trong một lần chạy, tổng cộng hơn 3.600 trang, vẫn duy trì độ chính xác và tốc độ xử lý cao khi độ dài tài liệu tăng lên.
Bí quyết kỹ thuật là cơ chế chú ý mà nhóm phát triển gọi là SR-SWA. Thay vì giữ mọi trang trong bộ nhớ cùng lúc, mô hình hoạt động như người chép một cuốn sách dài: nó quét về phía trước, chọn những trang và khối thông tin quan trọng cho đoạn đang xử lý, rồi gác phần còn lại sang một bên. Cơ chế giải mã theo khối sau đó lắp ráp đầu ra. Baidu cho biết cách tiếp cận này đã giảm mức dùng bộ nhớ đệm KV đỉnh trong bài thử nghiệm trăm trang từ 47 gigabyte xuống chỉ còn một phần nhỏ, giúp tài liệu dài trở nên khả thi trên phần cứng thông thường.
Theo công ty, các bộ đánh giá công khai cho phân tích tài liệu nhiều trang, gồm những bài kiểm tra tiền tố M được theo dõi rộng rãi, cho thấy mô hình đạt kết quả tốt nhất hiện nay. Baidu gọi đây là sự xuất hiện của kỷ nguyên OCR 3.0, khi phân tích tài liệu được đánh giá không phải bằng việc mô hình đọc một trang tốt đến đâu, mà bằng độ tin cậy khi xử lý cả một kho lưu trữ.
Ý nghĩa thực tiễn rất lớn. Hợp đồng, hồ sơ tòa án, bệnh án, kho lưu trữ lịch sử và thư viện học thuật đều đến dưới dạng những chồng trang quét. Một mô hình có thể nạp tất cả trong một lượt có thể thay đổi cách các công ty luật, bệnh viện và nhà xuất bản số hóa kho tài liệu tồn đọng. Nó cũng có thể đưa tài liệu dài thẳng vào trợ lý AI, vốn gặp khó khăn với cửa sổ ngữ cảnh và truy xuất thông tin khi được yêu cầu suy luận qua hàng trăm trang.
Việc mã nguồn mở mô hình hạ thấp rào cản cho các nhà phát triển muốn xây dựng công cụ tài liệu mà không phải trả phí theo trang cho nhà cung cấp đám mây. Baidu đang định vị dòng Wenxin làm nền tảng cho cả sản phẩm của mình lẫn nhà phát triển bên ngoài, và việc phát hành miễn phí mô hình OCR phù hợp với chiến lược đó.
Tuyên bố về số trang không giới hạn chắc chắn sẽ thu hút sự soi xét. Các bài kiểm tra độc lập cần xác nhận độ chính xác vẫn giữ được trên những bản quét lộn xộn ngoài đời thực, chữ viết tay và bảng biểu, chứ không chỉ những trang sách sạch sẽ. Dù vậy, bản demo vẫn rất ấn tượng: một mô hình duy nhất đọc trọn cả bộ bảy cuốn trong một lần là kiểu thước đo cụ thể dễ đọng lại trong tâm trí.
Với độc giả toàn cầu, đây là lời nhắc rằng các phòng thí nghiệm AI của Trung Quốc đang cạnh tranh gay gắt cả về kỹ thuật thực tiễn lẫn quy mô mô hình gây chú ý. Phân tích tài liệu là công việc kém hào nhoáng, nhưng nó là nền tảng cho phần lớn việc ứng dụng AI trong doanh nghiệp. Nếu mô hình hoạt động đúng như quảng cáo, chiến trường tiếp theo sẽ là ai biến hiểu biết tài liệu dài thành công cụ văn phòng hằng ngày trước.