百度新 OCR 模型一次讀完七部《哈利波特》
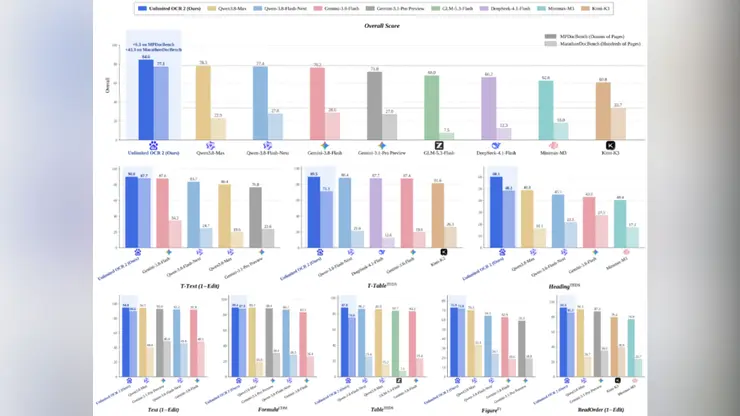
光學字元辨識這項把文字圖片轉為可編輯文字的技術,長久以來都有上限。多數系統處理幾十頁後,準確率便會下滑,記憶體用量也會暴增。10 月 27 日,百度發布並開源了名為文心 Unlimited OCR 2 的模型,宣稱徹底移除了這道限制。
該公司稱,這是首次有模型實現任意頁數的文件解析,把處理上限從數十頁推向其所謂的無限。在一場演示中,該模型單次運行便讀完全部七部《哈利波特》小說,合計超過 3,600 頁,且隨著文件長度增加,仍維持高準確率與處理速度。
技術關鍵在於團隊稱為 SR-SWA 的注意力機制。模型不會一次把所有頁面都放進記憶體,而是像人抄寫長篇書籍那樣運作:向前掃描,挑出與當前段落相關的頁面與資訊區塊,其餘暫且擱置。接著由分塊解碼機制組裝輸出。百度表示,這種做法讓百頁測試中的 KV 快取峰值用量從 47 GB 降到僅為其一小部分,使長文件在普通硬體上也能實際運行。
據該公司說法,在多頁文件解析的公開基準測試中,包括備受關注的 M 系列測試,該模型都達到最先進的結果。百度將此次發布定調為 OCR 3.0 時代的到來:評判文件解析的標準不再是模型讀單頁有多好,而是它處理整座檔案庫有多可靠。
實際影響甚鉅。合約、法院卷宗、病歷、歷史檔案與學術圖書館,送來的都是一疊疊掃描頁面。能一次吞下這些內容的模型,可能改變律師事務所、醫院與出版社數位化積壓文件的方式。它也能把長文件直接餵給 AI 助理,而這些助理在需要跨數百頁推理時,往往受制於上下文視窗與檢索能力。
開源該模型降低了開發者的門檻,讓他們不必向雲端供應商支付按頁計費的費用,就能打造文件工具。百度一直將文心系列定位為自家產品與外部開發者的基礎,免費釋出這款 OCR 模型正符合這項策略。
「無限頁數」的說法勢必引來檢視。獨立測試需要確認,準確率在混亂的現實掃描件、手寫字跡與表格上依然成立,而不只是在乾淨的書頁上。儘管如此,這場演示仍相當醒目:單一模型一次讀完整套七部系列作,正是那種容易讓人記住的具體標竿。
對全球讀者而言,這次發布提醒人們,中國的 AI 實驗室不只在模型規模上較勁,在實用工程上也競爭激烈。文件解析是毫不起眼的工作,卻是企業採用 AI 的龐大基礎。若該模型表現一如宣傳,下一個戰場將是誰先把長文件理解變成日常辦公工具。