Các nhà nghiên cứu Google phát hiện lỗi làm tròn âm thầm phá hỏng quá trình huấn luyện AI
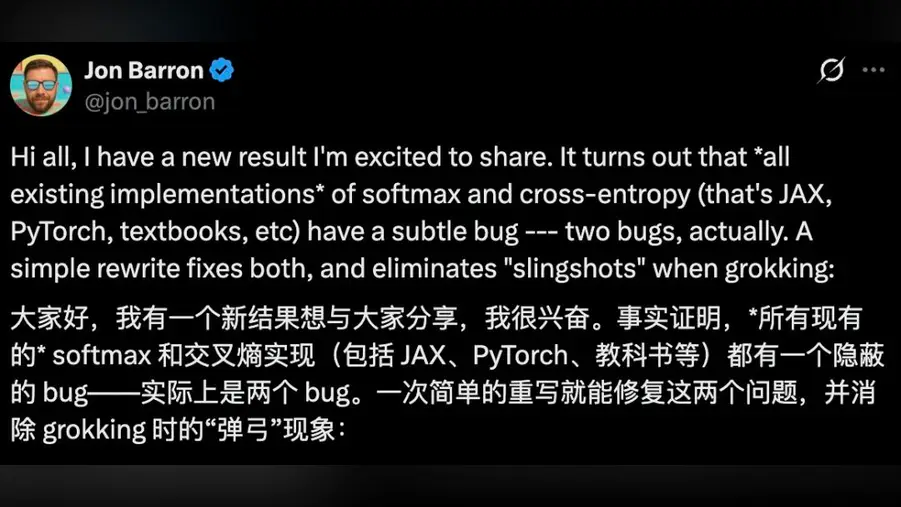
Một nhà khoa học nghiên cứu cấp cao tại Google DeepMind, Jon Barron, đã chỉ ra một lỗi đánh máy với hậu quả nghiêm trọng: trong các triển khai tiêu chuẩn của một thuật toán huấn luyện được sử dụng rộng rãi, một con số lẽ ra phải mang thông tin đang bị làm tròn xuống thành 0 một cách âm thầm. Lỗi này xuất hiện trong PyTorch và JAX, hai khung phần mềm phổ biến nhất để xây dựng mô hình AI, và trong công thức được in trong sách giáo khoa.
Tác động không phải là sự cố sập chương trình. Đó là một sự rò rỉ chậm. Mô hình càng tự tin về một dự đoán, tín hiệu huấn luyện đúng càng dễ biến mất vào bước làm tròn đó. Khi tín hiệu điều chỉnh biến mất, bộ tối ưu hóa điều chỉnh trọng số của mô hình mất chỗ đứng, và đường cong huấn luyện dao động thay vì ổn định. Nói một cách đơn giản, sự chắc chắn của mô hình có thể xóa đi chính phản hồi được thiết kế để sửa nó.
Lý do vấn đề này vượt ra ngoài một hội thảo nghiên cứu là quy mô. PyTorch và JAX là nền tảng cho hầu hết các mô hình ngôn ngữ lớn và trình tạo hình ảnh đang được sử dụng thương mại, từ các phòng thí nghiệm Mỹ đến các nhà phát triển Trung Quốc như DeepSeek và nhóm Qwen của Alibaba, những đơn vị công bố các mô hình mở được xây dựng trên cùng một chuỗi công cụ. Một lỗi số học tinh vi trong một thư viện dùng chung là một trong số ít thứ có thể ảnh hưởng đến các đối thủ ở cả hai bờ Thái Bình Dương cùng lúc.
Theo báo cáo, mô hình Gemini của Google đã có thể xác định và sau đó khắc phục vấn đề trong thiết lập huấn luyện của chính nó, một minh chứng sớm về việc mô hình kiểm toán mã nguồn tạo ra mô hình. Chi tiết đó có khả năng thu hút sự chú ý không kém gì bản thân lỗi, vì nó cho thấy việc đánh giá tự động các quy trình huấn luyện có thể trở nên thường quy thay vì mới lạ.
Các câu hỏi thực tế không hào nhoáng nhưng lớn. Bao nhiêu phần trong khoảng cách giữa một quá trình huấn luyện ổn định và một quá trình chao đảo là do bước làm tròn này? Có phải một số mô hình bị coi là khó huấn luyện trong khi lỗi nằm ở mặc định của thư viện? Và bao nhiêu so sánh điểm chuẩn đã công bố, kể cả những so sánh dùng để xếp hạng mô hình Trung Quốc và Mỹ với nhau, dựa trên các quá trình huấn luyện mang lỗi đó?
Đối với các nhóm bên ngoài những phòng thí nghiệm lớn, bài học trước mắt là kiểm chứng. Các mặc định của khung phần mềm được hầu hết kỹ sư coi là chân lý, và công thức sách giáo khoa còn hơn thế. Một hằng số bị chỉ định sai có thể lan truyền qua quá trình tinh chỉnh, chưng cất và đánh giá mà không ai nhận ra, vì đầu ra vẫn trông giống một mô hình hoạt động, chỉ là kém ổn định hơn.
Điểm rộng hơn là về nguồn gốc của tiến bộ AI hiện nay. Phần lớn bước nhảy gần đây được ghi công cho các cụm máy tính lớn hơn và nhiều dữ liệu hơn. Sự việc này là lời nhắc nhở rằng hệ thống số học bên dưới, những phần không ai trình diễn, vẫn định hình những gì mô hình có thể học. Sửa một quy tắc làm tròn sẽ không gây chú ý như một bản phát hành mô hình mới, nhưng nó có thể thay đổi đường cong huấn luyện cho tất cả những ai áp dụng bản sửa lỗi.