Googleの研究者、AIトレーニングを静かに壊す丸め誤差を発見
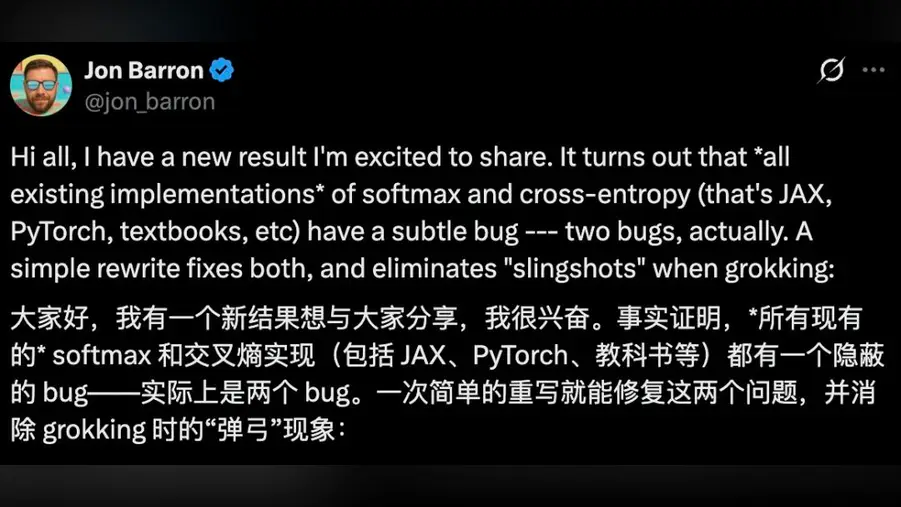
Google DeepMindの上級研究員ジョン・バロン氏は、結果を伴うタイプミスとも言える問題を指摘した。広く使われるトレーニングアルゴリズムの標準実装において、情報を担うはずの数値が静かにゼロに切り捨てられているのだ。このバグは、AIモデル構築で最も一般的なソフトウェアフレームワークであるPyTorchとJAX、そして教科書に印刷された数式に現れている。
その影響はクラッシュではない。ゆっくりとした漏れだ。モデルが予測に自信を持つほど、正しいトレーニング信号がこの丸めのステップで消えやすくなる。修正信号が失われると、モデルの重みを調整するオプティマイザは足場を失い、トレーニング曲線は落ち着くどころか振動する。平たく言えば、モデルの確信が、それを正すためのフィードバックそのものを消し去りかねないのだ。
これが研究セミナーの域を超えて重要なのは、規模ゆえだ。PyTorchとJAXは、米国のラボからDeepSeekやAlibabaのQwenチームのような中国の開発者まで、商用利用される大規模言語モデルや画像生成器の大半を支えている。同じツールチェーン上で構築されたオープンモデルを公開しているからだ。共有ライブラリの微妙な算術的欠陥は、太平洋の両側の競合他社に同時に影響しうる数少ないものの一つである。
報告によれば、GoogleのGeminiモデルは自身のトレーニング設定で問題を特定し、修正することができた。モデルがモデルを構築するコードを監査する初期の実例だ。この詳細はバグ自体と同じくらい注目を集めるだろう。トレーニングパイプラインの自動レビューが珍事ではなく日常になりうることを示唆しているからだ。
実務的な問いは地味だが大きい。安定したトレーニングと揺らぐトレーニングの差のどれだけがこの丸めのせいだったのか。ライブラリのデフォルトに原因があったのに、学習が難しいと切り捨てられたモデルはあったのか。そして、中国と米国のモデルを互いにランク付けするのに使われるものを含め、公表されたベンチマーク比較のどれだけが、この欠陥を抱えたトレーニングに基づいているのか。
大手ラボの外のチームにとって、当面の教訓は検証だ。フレームワークのデフォルトはほとんどのエンジニアに絶対の真実と見なされ、教科書の数式はなおさらだ。一つの誤った定数が、ファインチューニング、蒸留、評価を通じて誰にも気づかれずに伝播しうる。出力は依然として動くモデルに見えるからだ。ただ、より不安定なだけである。
より広い論点は、AIの進歩が今どこから来るのかということだ。最近の飛躍の多くは、より大きなクラスタとより多くのデータのおかげとされてきた。今回の一件は、誰もデモしない下部の数値的な配管が、モデルが何を学べるかを依然として形作っていることの提醒である。丸め規則の修正は、新モデル発表のようには見出しにならないだろうが、修正を採用する全員のトレーニング曲線を変えるかもしれない。