باحثون في جوجل يكتشفون خطأ تقريب يُفسد تدريب الذكاء الاصطناعي بصمت
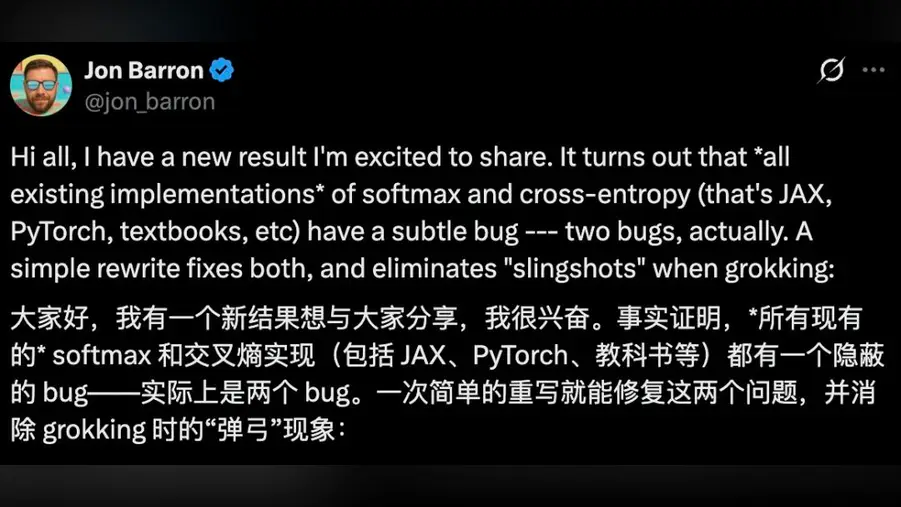
أشار جون بارون، كبير الباحثين في Google DeepMind، إلى ما يعادل خطأ مطبعي بعواقب: في التطبيقات القياسية لخوارزمية تدريب واسعة الاستخدام، يُقرَّب رقم كان ينبغي أن يحمل معلومة إلى الصفر بصمت. يظهر الخطأ في PyTorch وJAX، وهما من أكثر أطر البرمجيات شيوعًا لبناء نماذج الذكاء الاصطناعي، وفي الصيغة المطبوعة في الكتب المدرسية.
الأثر ليس انهيارًا. إنه تسرّب بطيء. فكلما زادت ثقة النموذج بتوقعه، زاد احتمال تلاشي إشارة التدريب الصحيحة في خطوة التقريب تلك. وبغياب الإشارة التصحيحية، يفقد المُحسِّن الذي يضبط أوزان النموذج ثباته، ويتأرجح منحنى التدريب بدل أن يستقر. وبعبارة بسيطة، قد تمحو ثقة النموذج التغذية الراجعة نفسها التي وُجدت لتصحيحه.
سبب أهمية هذا خارج ندوة بحثية هو الحجم. فـ PyTorch وJAX تدعم معظم النماذج اللغوية الكبيرة ومولّدات الصور المستخدمة تجاريًا، من المختبرات الأمريكية إلى مطورين صينيين مثل DeepSeek وفريق Qwen في علي بابا، الذين ينشرون نماذج مفتوحة مبنية على السلسلة الأدواتية نفسها. والخلل الحسابي الدقيق في مكتبة مشتركة هو أحد الأشياء القليلة التي يمكن أن تمس المنافسين على جانبي المحيط الهادئ في آن واحد.
وفقًا للرواية، تمكن نموذج Gemini من جوجل من تحديد المشكلة ثم تصحيحها في إعداد التدريب الخاص به، وهو عرض مبكر لنموذج يدقق الشيفرة التي تبني النماذج. ومن المرجح أن يجذب هذا التفصيل قدرًا من الاهتمام يعادل الخطأ نفسه، لأنه يشير إلى أن المراجعة الآلية لخطوط أنابيب التدريب قد تصبح روتينًا لا نادرة.
الأسئلة العملية غير مبهرة لكنها كبيرة. كم من الفجوة بين تدريب منضبط وآخر مضطرب كان بسبب خطوة التقريب هذه؟ وهل استُبعدت بعض النماذج باعتبارها صعبة التدريب بينما كان العيب في إعداد افتراضي للمكتبة؟ وكم من مقارنات المعايير المنشورة، بما فيها تلك المستخدمة لترتيب النماذج الصينية والأمريكية مقابل بعضها، يقوم على تدريبات حملت هذا الخلل؟
بالنسبة للفرق خارج المختبرات الكبرى، الدرس المباشر هو التحقق. فالإعدادات الافتراضية للأطر يعتبرها معظم المهندسين حقيقة مطلقة، وصيغ الكتب المدرسية أكثر من ذلك. وثابت واحد خاطئ التحديد قد ينتشر عبر الضبط الدقيق والتقطير والتقييم دون أن يلاحظ أحد، لأن المخرجات لا تزال تبدو كنموذج يعمل، لكنه أقل استقرارًا فحسب.
النقطة الأوسع تتعلق بمصدر التقدم في الذكاء الاصطناعي اليوم. فقد نُسب الكثير من القفزة الأخيرة إلى عناقيد أكبر وبيانات أكثر. هذه الحادثة تذكّر بأن السباكة العددية في الأسفل، الأجزاء التي لا يعرضها أحد، لا تزال تشكّل ما يمكن للنماذج تعلمه. إصلاح قاعدة تقريب لن يتصدر العناوين كما يفعل إطلاق نموذج جديد، لكنه قد يغيّر منحنيات التدريب لكل من يتبنى التصحيح.