Google 研究人員發現悄悄破壞 AI 訓練的捨入錯誤
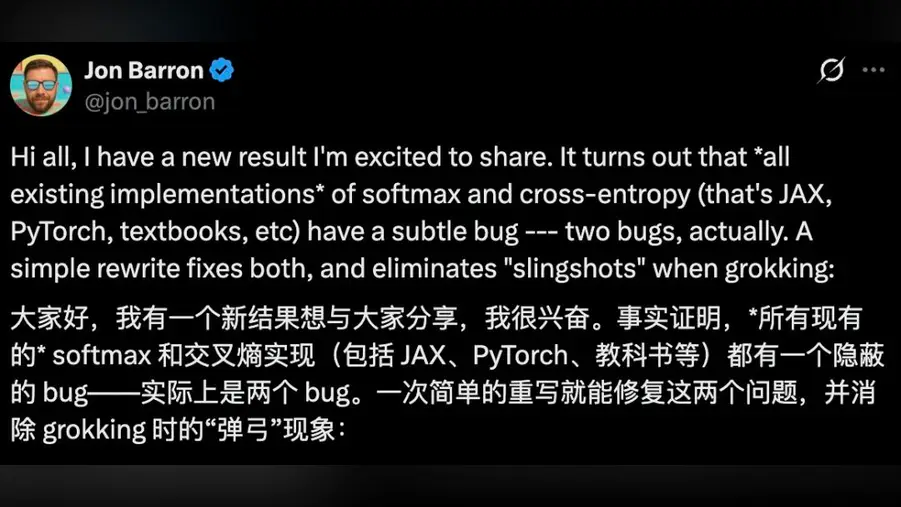
Google DeepMind 資深研究科學家 Jon Barron 指出一個後果嚴重的「錯字」:在一套廣泛使用的訓練演算法標準實作中,一個本應承載資訊的數字正被悄悄捨入為零。這個錯誤出現在 PyTorch 與 JAX 這兩個最常用的 AI 模型建構軟體框架中,也出現在教科書印出的公式裡。
影響並非程式崩潰,而是緩慢的洩漏。模型對某個預測越有信心,正確的訓練訊號就越可能消失在這個捨入步驟中。一旦修正訊號消失,調整模型權重的優化器便失去立足點,訓練曲線會擺盪而非收斂。簡單來說,模型的確定性可能抹除本應用來糾正它的回饋。
這件事的意義超越研究研討會,在於規模。PyTorch 與 JAX 支撐著商業使用中的大多數大型語言模型與影像生成器,從美國實驗室到 DeepSeek、阿里巴巴 Qwen 團隊等中國開發者,後者所發布的開放模型也建立在同一套工具鏈上。共享函式庫中一個細微的算術缺陷,是少數能同時影響太平洋兩岸競爭對手的問題之一。
根據報導,Google 的 Gemini 模型能夠辨識並在其自身的訓練設定中修正這個問題,這是模型稽核建構模型之程式碼的早期示範。這個細節可能與錯誤本身同樣受到關注,因為它暗示訓練流程的自動化審查可能成為常規,而非新奇事物。
實際問題並不光鮮,但事關重大。一段表現良好的訓練與一段抖動的訓練之間的差距,有多少來自這個捨入步驟?是否有些模型被認定難以訓練,而過錯其實在於函式庫的預設值?又有多少已發表的基準比較——包括用來將中國與美國模型相互排名的比較——是建立在帶有這個缺陷的訓練之上?
對大型實驗室以外的團隊而言,當前的教訓是驗證。框架預設值被大多數工程師視為準則,教科書公式更是如此。一個指定錯誤的常數可能經由微調、蒸餾與評估一路傳播而無人察覺,因為輸出看起來仍像一個能運作的模型,只是較不穩定。
更廣泛的重點在於 AI 進展如今從何而來。近期的躍進大多歸功於更大的叢集與更多資料。這起事件提醒我們,底層的數值管線——那些沒有人會示範的部分——仍舊形塑模型能學到什麼。修正一條捨入規則不會像發布新模型那樣登上頭條,但可能改變所有採用此修正者的訓練曲線。