Peneliti Google Temukan Bug Pembulatan yang Diam-diam Merusak Pelatihan AI
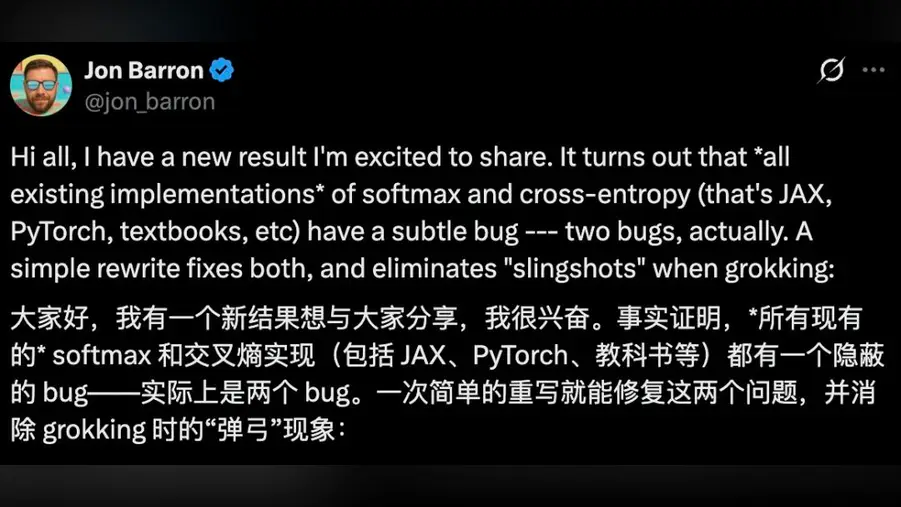
Seorang ilmuwan peneliti senior di Google DeepMind, Jon Barron, menyoroti apa yang pada dasarnya adalah salah ketik dengan konsekuensi: dalam implementasi standar algoritma pelatihan yang banyak digunakan, sebuah angka yang seharusnya membawa informasi diam-diam dibulatkan ke bawah menjadi nol. Bug ini muncul di PyTorch dan JAX, dua kerangka perangkat lunak paling umum untuk membangun model AI, dan dalam rumus yang tercetak di buku teks.
Efeknya bukan crash. Ini kebocoran lambat. Semakin percaya diri sebuah model terhadap suatu prediksi, semakin besar kemungkinan sinyal pelatihan yang benar hilang ke dalam langkah pembulatan itu. Dengan hilangnya sinyal korektif, optimizer yang menyesuaikan bobot model kehilangan pijakan, dan kurva pelatihan bergoyang alih-alih stabil. Secara sederhana, keyakinan model dapat menghapus umpan balik yang seharusnya mengoreksinya.
Mengapa ini penting di luar seminar riset adalah skalanya. PyTorch dan JAX mendasari sebagian besar model bahasa besar dan generator gambar yang digunakan secara komersial, dari laboratorium Amerika hingga pengembang China seperti DeepSeek dan tim Qwen Alibaba, yang menerbitkan model terbuka yang dibangun di atas rantai alat yang sama. Cacat aritmetika halus dalam pustaka bersama adalah salah satu dari sedikit hal yang dapat memengaruhi pesaing di kedua sisi Pasifik sekaligus.
Menurut laporan tersebut, model Gemini Google mampu mengidentifikasi dan kemudian memperbaiki masalah dalam pengaturan pelatihannya sendiri, sebuah demonstrasi awal model yang mengaudit kode yang membangun model. Detail itu kemungkinan akan menarik perhatian sebanyak bug itu sendiri, karena menunjukkan tinjauan otomatis terhadap pipeline pelatihan bisa menjadi rutin alih-alih hal baru.
Pertanyaan praktisnya tidak glamor tetapi besar. Berapa banyak dari kesenjangan antara pelatihan yang berperilaku baik dan yang bergetar disebabkan oleh langkah pembulatan ini? Apakah beberapa model dianggap sulit dilatih padahal kesalahannya terletak pada default pustaka? Dan berapa banyak perbandingan benchmark yang diterbitkan, termasuk yang digunakan untuk memeringkat model China dan Amerika satu sama lain, yang bertumpu pada pelatihan yang membawa cacat tersebut?
Bagi tim di luar laboratorium besar, pelajaran langsungnya adalah verifikasi. Default kerangka kerja dianggap sebagai kebenaran dasar oleh sebagian besar insinyur, dan rumus buku teks bahkan lebih lagi. Satu konstanta yang salah spesifikasi dapat menyebar melalui fine-tuning, distilasi, dan evaluasi tanpa ada yang menyadarinya, karena outputnya masih terlihat seperti model yang berfungsi, hanya kurang stabil.
Poin yang lebih luas adalah tentang dari mana kemajuan AI sekarang berasal. Sebagian besar lompatan terbaru dikreditkan ke kluster yang lebih besar dan lebih banyak data. Episode ini adalah pengingat bahwa perpipaan numerik di bawahnya, bagian yang tidak didemokan siapa pun, masih membentuk apa yang dapat dipelajari model. Memperbaiki aturan pembulatan tidak akan menjadi berita utama seperti rilis model baru, tetapi mungkin mengubah kurva pelatihan bagi semua orang yang mengadopsi koreksi tersebut.