DeepSeek Mã Nguồn Mở DeepInfer, Cỗ Máy Đằng Sau Lưu Lượng Chat Của Chính Mình
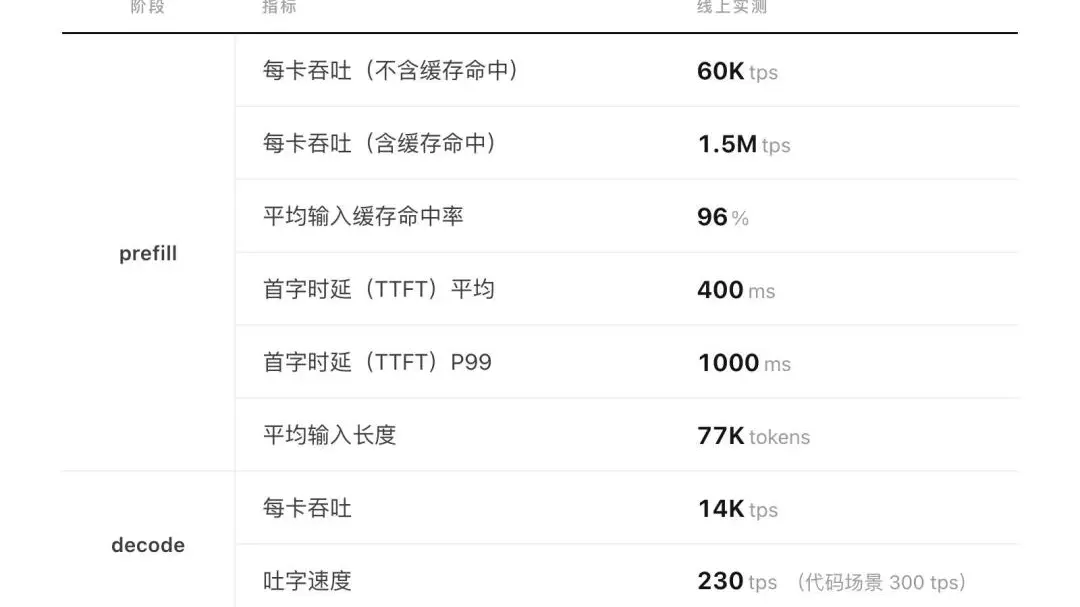
DeepSeek đã công bố DeepInfer, khung suy luận nội bộ cung cấp năng lượng cho việc phục vụ mô hình quy mô sản xuất của mình, theo giấy phép Apache 2.0 linh hoạt vào ngày 20 tháng 10, cùng với deepseek-recipe, một thành phần mã hóa và giải mã token đi kèm. Bản phát hành hiện hỗ trợ DeepSeek-V4.1-Flash.
Khung này bao gồm các toán tử hiệu suất cao và một công cụ tối ưu hóa, đồng thời bổ sung suy luận phân tán, giải mã suy đoán, đầu ra có cấu trúc và một kỹ thuật tiết kiệm bộ nhớ mà công ty gọi là SWA Bounded Replay. Nó chạy trên cả phần cứng Nvidia và chip Ascend của Huawei, một chi tiết quan trọng đối với các nhà phát triển Trung Quốc không thể dựa vào GPU nhập khẩu.
DeepInfer theo một mô hình của DeepSeek: công ty đã mở trọng số mô hình, bộ công cụ biên dịch TileLang và thư viện toán tử suy luận của mình. Việc công bố lớp phục vụ cho phép các kỹ sư bên ngoài tái tạo lợi ích hiệu quả của công ty thay vì thiết kế ngược chúng, và mang đến cho các nhóm nhỏ hơn một con đường sẵn có để chạy các mô hình lớn với chi phí thấp.
Động thái này cũng âm thầm nâng cao tiêu chuẩn cho các đối thủ. Chi phí suy luận, chứ không phải chất lượng mô hình thô, ngày càng quyết định sản phẩm AI nào tồn tại ở quy mô lớn, và DeepSeek đang trao lợi thế chi phí của mình cho bất kỳ ai muốn.