ロボット訓練データを数百万時間規模で生み出す杭州のセンターの内側
ロボットに洗濯物を畳ませたり棚に商品を並べさせたりするには、膨大な動画と動作データが必要になる。機械が物に触れたとき物体がどう振る舞うかをモデルに教える、そうしたマルチモーダルなインタラクション映像だ。実用的な身体性AIモデルには数千万時間規模が必要というのが業界の共通認識である。だが業界全体が2年をかけて取り組んだ末に実際に存在するのは約100万時間で、低品質のクリップを取り除けば本当に使えるものはさらに少ない。
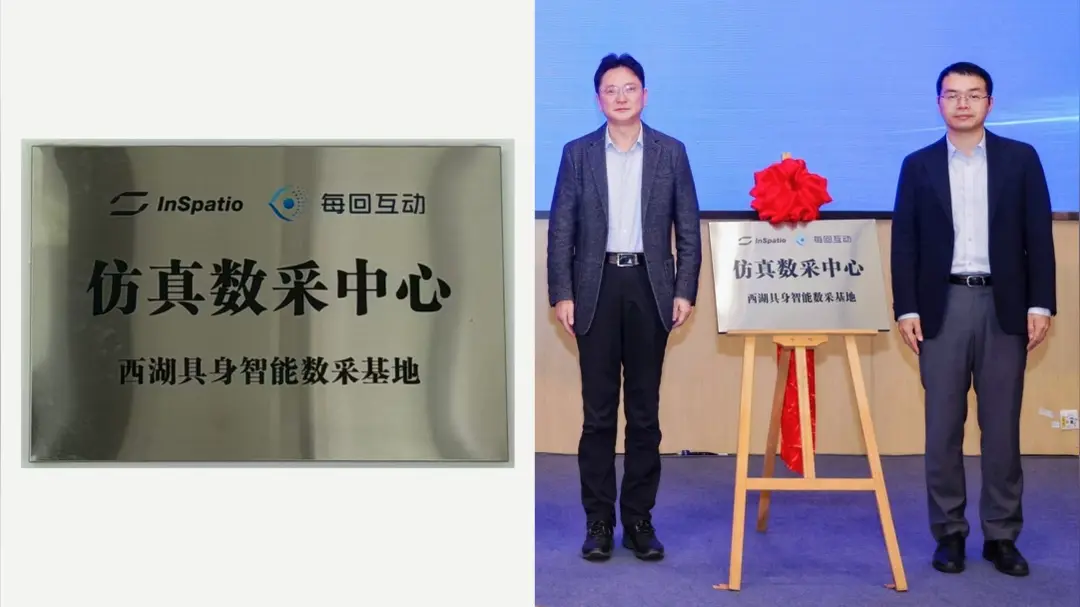
この隔たりが、杭州の新施設の事業根拠になっている。国内初の身体性シミュレーション・データ収集センターとされ、Yingsuという企業が運営する。同社の主張は、ボトルネックは決してデータそのものではなかったというものだ。問題は手法にあった。従来の式は「人数×時間」であり、人間のオペレーターがロボットアームを操作したりモーションキャプチャースーツを着たりして、使える1分1分を生み出していた。
同社が描く新しい式は「環境設定×並列計算能力」だ。1台のロボットが1つの部屋で1つの作業をするのを撮影する代わりに、センターはシミュレーション環境を構築し、多数を同時に走らせ、多様なシーンや照明、物体の配置、物理的な相互作用を並列に生成する。業界のある報告書は、1日300万のサンドボックスを生成できる関連手法を紹介している。能力の単位は、オペレーターのシフトからGPUクラスターの処理能力へと移る。
この移行が重要なのは、誰が競争できるかを変えるからだ。人手による収集は始めるのは安いが、線形にしか拡張できず、一貫性の維持も難しい。シミュレーションはハードウェアとともに拡張するが、正確な物理、入念なドメインランダム化、そして合成映像と実映像の隔たりを埋める手段が要る。シミュレーションに偏りすぎれば、ロボットはどの厨房や倉庫にも存在しない、きれいで協力的な物理を学んでしまう。センターが掲げる狙いは、単に時間の山をもう一つ積むことではなく、この中核的なボトルネックを打ち破ることにある。
このタイミングは、中国の身体性AIをめぐる広い空気を映している。ヒューマノイドロボットメーカーは多額の投資と強い社会的関心を集めてきた。ハードウェアはそれを有用にするソフトウェアより速く進み、データが認められた制約となった。データ生産を産業プロセスとして扱う施設、つまり設定可能で並列かつ反復可能なものとする施設は、経験を記録するだけでなく製造できる者が勝つという賭けだ。
残る問いは品質である。合成映像が価値を持つのは、主にシミュレーター内で訓練されたモデルが、実機のロボットが未知の部屋に入っても機能する場合だけだ。これはロボット工学者が長年追ってきたシム・トゥ・リアルの問題そのもので、規模だけでは解決していない。センターの真の試練は、吐き出すデータが実験室の外でも確実に動くロボットを生み出せるかどうかにある。
世界の読者にとって、これは単一の施設というより進む方向の話だ。中国の身体性AI企業は、データ収集を計算問題として扱うことで10年分を数か月に圧縮しようとしている。この手法が機能すれば、有能なロボットの頭脳を訓練するコストは急落し、次の制約は映像ではなくハードウェア、配備、安全性になる。