走進杭州這座每月產出百萬小時機器人訓練資料的中心
訓練機器人折衣服或整理貨架,需要大量影片與動作資料——也就是教會模型理解機器觸碰物體時物件如何反應的多模態互動影像。業界普遍認為,一個可用的具身智慧模型需要數千萬小時這類資料。然而整個產業努力兩年後,實際存在的只有約一百萬小時,而且剔除低品質片段後,真正可用的還遠少於此。
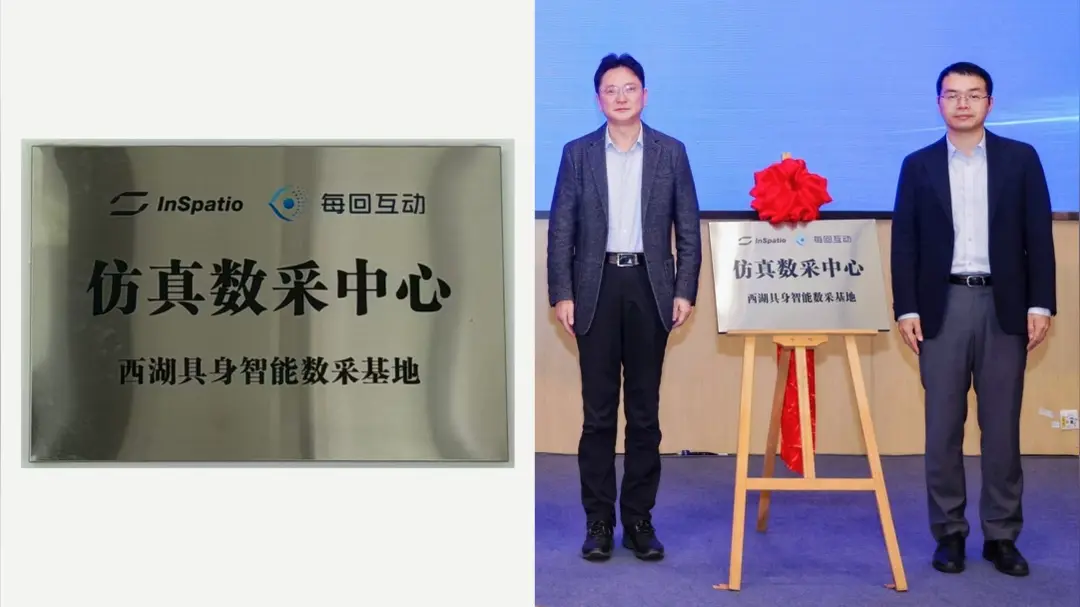
這個落差,正是杭州一座新設施的商業立基。它被稱為中國首座具身模擬資料採集中心,由一家名為銀粟的公司營運。其論點是:瓶頸從來不在資料本身,而在方法。舊公式是人力乘以工時,由操作員操控機械手臂或穿戴動作捕捉設備,才能產出每一分鐘可用資料。
該公司所描述的新公式,則是環境配置乘以平行運算能力。這座中心不拍攝單一機器人在單一房間執行單一任務,而是建構模擬環境並同時運行多個環境,平行生成多樣的場景、光照、物件擺放與物理互動。業界一份報告提到,類似做法一天可產出三百萬個沙盒。產能單位也從操作員的班次,轉變為 GPU 叢集的吞吐量。
這項轉變之所以重要,在於它改變了誰能參與競爭。人工採集起步便宜,但只能線性擴張,且難以維持一致;模擬則隨硬體擴充,卻要求精確的物理、謹慎的域隨機化,以及縮小合成與真實影像落差的方法。模擬過多,機器人學到的是乾淨、配合的物理環境,而任何廚房或倉庫都不會如此。該中心宣稱的目標,是突破這個核心瓶頸,而非只是再堆上一批工時。
時機也反映了中國具身智慧領域的整體氛圍:人形機器人製造商吸引了大筆投資與高度關注。硬體進展快於讓它真正有用的軟體,而資料已成為公認的制約。把資料生產視為工業流程——可配置、可平行、可重複——的設施,押注的是贏家將屬於能「製造」經驗、而非只是「記錄」經驗的人。
未解的問題是品質。合成影像唯有在主要於模擬器中訓練的模型,於實體機器人進入陌生房間後仍能運作時才有價值。這正是機器人研究者追逐多年的 sim-to-real 難題,單靠規模並未解決。這座中心真正的考驗,在於它產出的資料能否造就離開實驗室後仍可靠行事的機器人。
對全球讀者而言,重點不在單一設施,而在前進方向:中國具身智慧企業正試圖把十年的資料採集壓縮成幾個月,方法是把它當成運算問題。若這條路走得通,訓練一個夠格機器人大腦的成本將大幅下降,下一個制約就會是硬體、部署與安全,而非影像素材。