로봇 훈련 데이터를 수백만 시간 규모로 생산하는 항저우 센터의 내부
로봇에게 빨래를 개거나 선반에 물건을 쌓는 법을 가르치려면 방대한 영상과 동작 데이터가 필요하다. 기계가 물체에 닿을 때 물체가 어떻게 움직이는지를 모델에 가르치는 멀티모달 상호작용 영상이다. 쓸 만한 임바디드 AI 모델에는 수천만 시간이 필요하다는 것이 업계의 공통된 인식이다. 그러나 업계 전체가 2년간 노력한 끝에 실제로 존재하는 것은 약 100만 시간이며, 품질이 낮은 클립을 걸러내면 진짜 쓸 수 있는 양은 훨씬 적다.
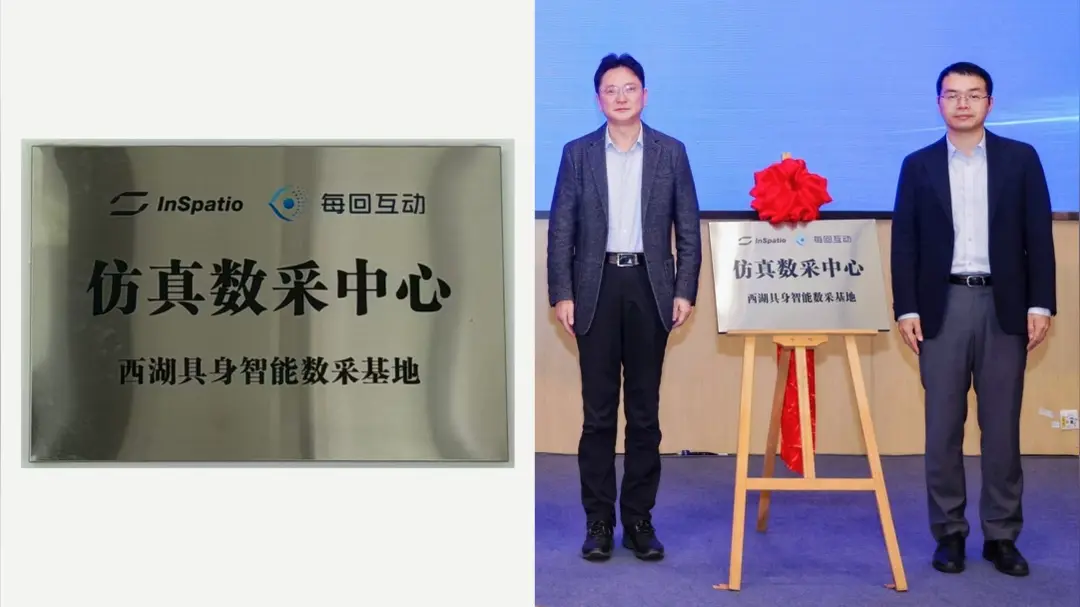
이 격차가 항저우의 새 시설이 내세우는 사업 근거다. 중국 최초의 임바디드 시뮬레이션 데이터 수집 센터로 소개되며, 잉쑤(Yingsu)라는 기업이 운영한다. 이 회사의 주장은 병목이 결코 데이터 자체에 있지 않았다는 것이다. 문제는 방법이었다. 기존 공식은 사람 곱하기 시간이었고, 인간 운영자가 로봇 팔을 조종하거나 모션 캡처 장비를 착용해 쓸 만한 1분 1분을 만들어냈다.
회사가 그리는 새 공식은 환경 구성 곱하기 병렬 컴퓨팅 성능이다. 로봇 한 대가 한 방에서 한 가지 작업을 하는 모습을 촬영하는 대신, 센터는 시뮬레이션 환경을 구축해 여러 개를 동시에 돌리며 다양한 장면과 조명, 물체 배치, 물리적 상호작용을 병렬로 생성한다. 업계의 한 보고서는 하루에 300만 개의 샌드박스를 만들 수 있는 관련 접근법을 소개한다. 역량의 단위가 운영자의 근무조에서 GPU 클러스터의 처리량으로 옮겨가는 것이다.
이 전환이 중요한 이유는 누가 경쟁할 수 있는지를 바꾸기 때문이다. 인력 기반 수집은 시작은 저렴하지만 선형으로만 확장되고 일관성을 유지하기 어렵다. 시뮬레이션은 하드웨어와 함께 확장되지만 정확한 물리, 세심한 도메인 무작위화, 그리고 합성 영상과 실제 영상 사이의 격차를 좁힐 방법이 필요하다. 시뮬레이션에 지나치게 치우치면 로봇은 어떤 주방이나 창고에도 존재하지 않는 깔끔하고 협조적인 물리를 배우게 된다. 센터가 내세우는 목표는 단순히 시간을 한 무더기 더 쌓는 것이 아니라 이 핵심 병목을 깨는 것이다.
시점은 중국 임바디드 AI 전반의 분위기를 반영한다. 휴머노이드 로봇 제조사들은 막대한 투자와 뜨거운 대중적 관심을 끌어왔다. 하드웨어는 이를 쓸모 있게 만드는 소프트웨어보다 빠르게 발전했고, 데이터는 공인된 제약 조건이 되었다. 데이터 생산을 구성 가능하고 병렬적이며 반복 가능한 산업 공정으로 다루는 시설은 경험을 단지 기록하는 것이 아니라 제조할 수 있는 쪽이 승자가 될 것이라는 베팅이다.
남은 질문은 품질이다. 합성 영상은 주로 시뮬레이터 안에서 훈련된 모델이 실제 로봇이 낯선 방에 들어가도 여전히 작동할 때만 가치가 있다. 이는 로봇공학 연구자들이 수년간 쫓아온 시뮬레이션-실제 격차 문제 그 자체이며, 규모만으로는 해결되지 않았다. 센터의 진짜 시험대는 내보내는 데이터가 실험실 밖에서도 안정적으로 작동하는 로봇을 만들어내는지 여부다.
전 세계 독자에게 이것은 단일 시설보다 나아가는 방향의 문제다. 중국 임바디드 AI 기업들은 데이터 수집을 컴퓨팅 문제로 다뤄 10년치를 몇 달로 압축하려 한다. 이 접근이 통하면 유능한 로봇 두뇌를 훈련하는 비용이 급격히 떨어지고, 다음 제약은 영상이 아니라 하드웨어와 배치, 안전이 된다.